Schlagwortarchiv: osbn

Tag OSBN

Eine OpenPGP-Smartcard, ein ThinkPad, GnuPG, Fedora und ich

Mit diesem Beitrag teile ich meine Erfahrungen mit der Inbetriebnahme einer OpenPGP–Smartcard und des Smartcard-Leser in meinem ThinkPad T14s Gen1. Ihr erfahrt, was alles zu tun war und was ich davon halte. Aber beginnen wir doch ganz am Anfang.

Motivation

Es war einmal die FrOSCon 2026. Dort sah ich am Merchandise-Stand im Foyer diese schicken OpenPGP-Smartcards und einige Karten-Lese/Schreib-Geräte ausliegen.

Ich sprach meine Bekannten auf ihre Erfahrungen mit diesen Karten und GnuPG an, welche überwiegend mit Kopfschütteln und Stöhnen reagierten. Offenbar sind sie nicht so leicht für etwas zu interessieren wie ich. Doch schien mir das Thema für den Moment weniger reizvoll und ich habe das Thema erstmal vertagt.

Das Thema ließ mich jedoch nicht los und so habe ich auf der Zugfahrt nach Hause nochmal nachgelesen, was es mit GnuPG und OpenPGP auf sich hat. Denn dass ich mich zuletzt damit beschäftigt hatte, war schon eine Weile her.

Mein ThinkPad T14s Gen1 besitzt einen Smartcard-Leser, den ich bisher noch nie verwendet hatte. Dieser lachte mich geradezu an und vielleicht half noch der ein oder andere Satz von Christian und ich bestellte mir die OpenPGP Smart Card V3.4 + MiFare DESFire im FLOSS-Shop.

Inbetriebnahme von Kartenleser und Erkennen der Karte

Das kann doch nicht so schwer sein. Das ist doch schnell erledigt.

Berühmte letzte Worte unbekannter Herkunft.
~]$ gpg --card-status
gpg: selecting card failed: No such device
gpg: OpenPGP card not available: No such device

Vorstehender Code-Block zeigt, dass es nicht auf Anhieb klappte. Dann halt erstmal Fehlersuche bzw. die Suche nach Dokumentation und Anleitungen.

Der erste Fehler war schnell gefunden. Der Smartcard-Leser war im UEFI noch deaktiviert. Ich habe die Angewohnheit, alle Geräte, die ich nicht regelmäßig verwende, dort abzuschalten. Nachdem der Kartenleser aktiviert war, wurde er auch von Linux erkannt – von gpg jedoch nicht.

Auf der Produktseite wird folgende URL zu Anleitungen und Erklärungen zu GnuPG, Kartenlesern mit und ohne Pinpad und zur Einrichtung und Verwendung der OpenPGP-Karte verlinkt: https://wiki.datenkollektiv.net/public/gnupg/gnupg-card-howto. Leider lieferte dieser Link einen HTTP-502-Fehler zurück, als ich die Seite gebraucht hätte. Also habe ich das Sprachmodell meiner Wahl um Rat gebeten, welches mir geraten hat, doch erstmal die erforderlichen Treiber und Tools zur Nutzung des Kartenlesers zu installieren. Na gut:

~]$ sudo dnf install pcsc-lite pcsc-lite-ccid pcsc-tools
~]$ sudo systemctl enable --now pcscd.service

Leider war es damit noch nicht getan und das Sprachmodell fing langsam das Halluzinieren an. Also bediente ich mich der Suchmaschine meines geringsten Misstrauens und recherchierte auf althergebrachte Weise. Ich war schon ziemlich genervt, als ich endlich einen passenden Hinweis in der Nitrokey-Dokumentation fand. Nachdem ich diese durchgearbeitet hatte, war ich einen großen Schritt weiter:

~]$ gpg --card-status
Reader ...........: Alcor Micro AU9540 00 00
Application ID ...: D27600012401030400050000DA260000
Application type .: OpenPGP
Version ..........: 3.4
Manufacturer .....: ZeitControl
Serial number ....: 0000DA26
Name of cardholder: [not set]
Language prefs ...: de
Salutation .......: 
URL of public key : [not set]
Login data .......: [not set]
Signature PIN ....: forced
Key attributes ...: rsa2048 rsa2048 rsa2048
Max. PIN lengths .: 64 64 64
PIN retry counter : 3 0 3
Signature counter : 0
KDF setting ......: off
Signature key ....: [none]
Encryption key....: [none]
Authentication key: [none]
General key info..: [none]

Die Karte wird von gpg erkannt, ist wie erwartet noch leer und kann nun endlich benutzt werden. Die Karte ist mit einer PIN und einer Admin-PIN versehen, welche bei bestimmten Operationen bzw. zum Entsperren der Karte abgefragt werden. Beide PINs sind auf individuelle PINs zu ändern. Sonst ist das Ganze sinnlos (siehe --change-pin).

GPG-Schlüssel auf der Karte generieren

Ab hier hilft die Manpage gpg(1) weiter. Der folgende Code-Block zeigt die Abfolge von Befehlen zur Generierung von GPG-Schlüsseln auf der Karte:

~]$ gpg --edit-card

Reader ...........: Alcor Micro AU9540 00 00
Application ID ...: D27600012401030400050000DA260000
Application type .: OpenPGP
Version ..........: 3.4
Manufacturer .....: ZeitControl
Serial number ....: 0000DA26
Name of cardholder: [not set]
Language prefs ...: de
Salutation .......: 
URL of public key : [not set]
Login data .......: [not set]
Signature PIN ....: forced
Key attributes ...: rsa2048 rsa2048 rsa2048
Max. PIN lengths .: 64 64 64
PIN retry counter : 3 0 3
Signature counter : 0
KDF setting ......: off
Signature key ....: [none]
Encryption key....: [none]
Authentication key: [none]
General key info..: [none]

gpg/card> admin
Admin commands are allowed

gpg/card> generate
Make off-card backup of encryption key? (Y/n) Y

Please note that the factory settings of the PINs are
   PIN = '123456'     Admin PIN = '12345678'
You should change them using the command --change-pin

Please specify how long the key should be valid.
         0 = key does not expire
      <n>  = key expires in n days
      <n>w = key expires in n weeks
      <n>m = key expires in n months
      <n>y = key expires in n years
Key is valid for? (0) 
Key does not expire at all
Is this correct? (y/N) y

GnuPG needs to construct a user ID to identify your key.

Real name: Bob
Email address: bob@example.com
Comment: der Baumeister
You selected this USER-ID:
    "Bob (der Baumeister) <bob@example.com>"

Change (N)ame, (C)omment, (E)mail or (O)kay/(Q)uit? O
We need to generate a lot of random bytes. It is a good idea to perform
some other action (type on the keyboard, move the mouse, utilize the
disks) during the prime generation; this gives the random number
generator a better chance to gain enough entropy.
rogpg: Note: backup of card key saved to '/home/jkastning/.gnupg/sk_9C88B267003429CB.gpg'
gpg: revocation certificate stored as '/home/jkastning/.gnupg/openpgp-revocs.d/2B3FFC727504AFFAEF0C50C080B662D727FEFF5F.rev'
public and secret key created and signed.

pub   rsa2048 2026-10-23 [SC]
      2B3FFC727504AFFAEF0C50C080B662D727FEFF5F
uid                      Bob (der Baumeister) <bob@example.com>
sub   rsa2048 2026-10-23 [A]
sub   rsa2048 2026-10-23 [E]


gpg/card> list

Reader ...........: Alcor Micro AU9540 00 00
Application ID ...: D27600012401030400050000DA260000
Application type .: OpenPGP
Version ..........: 3.4
Manufacturer .....: ZeitControl
Serial number ....: 0000DA26
Name of cardholder: [not set]
Language prefs ...: de
Salutation .......: 
URL of public key : [not set]
Login data .......: [not set]
Signature PIN ....: forced
Key attributes ...: rsa2048 rsa2048 rsa2048
Max. PIN lengths .: 64 64 64
PIN retry counter : 3 0 3
Signature counter : 4
KDF setting ......: off
Signature key ....: 2B3F FC72 7504 AFFA EF0C  50C0 80B6 62D7 27FE FF5F
      created ....: 2026-10-23 18:42:38
Encryption key....: 35CD 7AA9 CADB CA74 6103  C261 9C88 B267 0034 29CB
      created ....: 2026-10-23 18:42:38
Authentication key: 04C5 D0D4 E501 B90A 51BF  85FE B6C6 967B EFF5 5EF9
      created ....: 2026-10-23 18:42:38
General key info..: 
pub  rsa2048/80B662D727FEFF5F 2026-10-23 Bob (der Baumeister) <bob@example.com>
sec>  rsa2048/80B662D727FEFF5F  created: 2026-10-23  expires: never     
                                card-no: 0005 0000DA26
ssb>  rsa2048/B6C6967BEFF55EF9  created: 2026-10-23  expires: never     
                                card-no: 0005 0000DA26
ssb>  rsa2048/9C88B267003429CB  created: 2026-10-23  expires: never     
                                card-no: 0005 0000DA26

gpg/card>

Fertig. Auf der Karte befinden sich nun je ein Schlüsselpaar zum Signieren, Ver- und Entschlüsseln und für die Authentisierung (z.B. an einem SSH-Dienst). Ein Backup und ein Widerrufszertifikat wurden in folgenden Pfaden gespeichert:

  • Backup: .gnupg/sk_9C88B267003429CB.gpg
  • Widerrufszertifikat: .gnupg/openpgp-revocs.d/2B3FFC727504AFFAEF0C50C080B662D727FEFF5F.rev

Das Off-Card-Backup enthält nur den Encryption Key, nicht aber den Primärschlüssel. Ich empfehle, beide Dateien sicher und offline aufzubewahren. Sie sollten nicht auf dem Host verbleiben, wo sie kompromittiert werden können. Die Schaltkreise auf der Smartcard verhindern, dass der geheime/private Schlüssel von der Karte ausgelesen werden kann. So ist auch eine nachträgliche Erstellung einer weiteren Sicherheitskopie nicht möglich. Achtung: Mit dem Off-Card-Backup können nicht alle Schlüssel wiederhergestellt werden. Dies wird in meinen Augen im GnuPG HOWTO nicht deutlich.

Mir ist bei der Generierung aufgefallen, dass ich weder das Verfahren noch die Schlüssellänge auswählen konnte. Es wurde RSA 2048 Bit gewählt. Das ist mir ehrlich gesagt zu kurz. Leider gibt weder gpg(1) noch das GnuPG Smartcard HOWTO Hinweise, ob sich die Schlüssellänge beeinflussen lässt. Erst durch Suchen und Ausprobieren habe ich herausgefunden, dass man diese Parameter mit dem Admin-Befehl key-attr ändern kann. Der folgende Code-Block zeigt den Weg dorthin:

~]$ gpg --edit-card
…
gpg/card> admin
Admin commands are allowed

gpg/card> key-attr
Changing card key attribute for: Signature key
Please select what kind of key you want:
   (1) RSA
   (2) ECC
Your selection? 2
Please select which elliptic curve you want:
   (1) Curve 25519 *default*
   (4) NIST P-384
   (6) Brainpool P-256
Your selection? 
The card will now be re-configured to generate a key of type: ed25519
Note: There is no guarantee that the card supports the requested
      key type or size.  If the key generation does not succeed,
      please check the documentation of your card to see which
      key types and sizes are supported.
Changing card key attribute for: Encryption key
Please select what kind of key you want:
   (1) RSA
   (2) ECC
Your selection?

Für die folgenden Beispiele nutze ich jedoch weiterhin den bereits erstellten rsa2048-Schlüssel.

Im Schlüsselbund des Hosts werden die Schlüssel wie folgt dargestellt:

~]$ gpg --list-keys
pub   rsa2048 2026-10-23 [SC]
      2B3FFC727504AFFAEF0C50C080B662D727FEFF5F
uid           [ultimate] Bob (der Baumeister) <bob@example.com>
sub   rsa2048 2026-10-23 [A]
sub   rsa2048 2026-10-23 [E]

~]$ gpg --list-secret-keys
sec>  rsa2048 2026-10-23 [SC]
      2B3FFC727504AFFAEF0C50C080B662D727FEFF5F
      Card serial no. = 0005 0000DA26
uid           [ultimate] Bob (der Baumeister) <bob@example.com>
ssb>  rsa2048 2026-10-23 [A]
ssb>  rsa2048 2026-10-23 [E]

Zuerst werden die öffentlichen Schlüssel angezeigt, die im Schlüsselbund des Hosts gespeichert sind. Ich empfehle, diese ebenfalls zu sichern und auf einem anderen Medium aufzubewahren. Gehen sie verloren, können sie nicht mithilfe der Smartcard rekonstruiert werden. Anschließend werden Informationen zu den privaten Schlüsseln ausgegeben. Das ‚>‘ hinter den Schlüsseln zeigt an, dass sich die geheimen/privaten Schlüssel auf einer Smartcard befinden und nicht im Schlüsselbund vorliegen.

Eine Datei signieren

Schlüsseloperationen funktionieren wie gewohnt. Statt der Passphrase wird man nach der PIN der Smartcard gefragt. Im folgenden Beispiel signiere ich eine Textdatei, wobei ich explizit angebe, welche User-ID für die Signatur benutzt werden soll. Anschließend verifiziere ich die Signatur:

~]$ gpg --sign --local-user bob@example.com datei
~]$ gpg --verify datei
datei      datei.gpg  
[jkastning@t14s ~]$ gpg --verify datei.gpg 
gpg: Signature made Fr 23 Okt 2026 21:31:44 CEST
gpg:                using RSA key 4384D92F686DC876A3CFF458E8AF43DE9E151FF3
gpg:                issuer "bob@example.com"
gpg: checking the trustdb
gpg: marginals needed: 3  completes needed: 1  trust model: pgp
gpg: depth: 0  valid:   2  signed:   1  trust: 0-, 0q, 0n, 0m, 0f, 2u
gpg: depth: 1  valid:   1  signed:   0  trust: 0-, 0q, 0n, 0m, 1f, 0u
gpg: next trustdb check due at 2030-06-22
gpg: Good signature from "Bob (der Baumeister) <bob@example.com>" [ultimate]

Die Karte auf Werkseinstellungen zurücksetzen

Soll das Schlüsselmaterial von der Karte entfernt werden, z.B. weil man sie weitergeben möchte, kann sie wie folgt auf Werkseinstellungen zurückgesetzt werden:

~]$ gpg --edit-card

Reader ...........: Alcor Micro AU9540 00 00
Application ID ...: D27600012401030400050000DA260000
Application type .: OpenPGP
Version ..........: 3.4
Manufacturer .....: ZeitControl
Serial number ....: 0000DA26
Name of cardholder: [not set]
Language prefs ...: de
Salutation .......: 
URL of public key : [not set]
Login data .......: [not set]
Signature PIN ....: forced
Key attributes ...: rsa2048 rsa2048 rsa2048
Max. PIN lengths .: 64 64 64
PIN retry counter : 3 0 3
Signature counter : 5
KDF setting ......: off
Signature key ....: 4384 D92F 686D C876 A3CF  F458 E8AF 43DE 9E15 1FF3
      created ....: 2026-10-23 19:29:37
Encryption key....: 245E CD79 8DF9 D0FE 233B  9C95 D955 9262 22CF B708
      created ....: 2026-10-23 19:29:37
Authentication key: 7C86 CC37 9C74 776B 162E  AE31 FD5C 43DB 9DCD 233E
      created ....: 2026-10-23 19:29:37
General key info..: 
pub  rsa2048/E8AF43DE9E151FF3 2026-10-23 Bob (der Baumeister) <bob@example.com>
sec>  rsa2048/E8AF43DE9E151FF3  created: 2026-10-23  expires: never     
                                card-no: 0005 0000DA26
ssb>  rsa2048/FD5C43DB9DCD233E  created: 2026-10-23  expires: never     
                                card-no: 0005 0000DA26
ssb>  rsa2048/D955926222CFB708  created: 2026-10-23  expires: never     
                                card-no: 0005 0000DA26

gpg/card> admin
Admin commands are allowed

gpg/card> factory-reset
gpg: OpenPGP card no. D27600012401030400050000DA260000 detected

gpg: Note: This command destroys all keys stored on the card!

Continue? (y/N) y
Really do a factory reset? (enter "yes") yes

gpg/card> list

Reader ...........: Alcor Micro AU9540 00 00
Application ID ...: D27600012401030400050000DA260000
Application type .: OpenPGP
Version ..........: 3.4
Manufacturer .....: ZeitControl
Serial number ....: 0000DA26
Name of cardholder: [not set]
Language prefs ...: de
Salutation .......: 
URL of public key : [not set]
Login data .......: [not set]
Signature PIN ....: forced
Key attributes ...: rsa2048 rsa2048 rsa2048
Max. PIN lengths .: 64 64 64
PIN retry counter : 3 0 3
Signature counter : 0
KDF setting ......: off
Signature key ....: [none]
Encryption key....: [none]
Authentication key: [none]
General key info..: [none]

gpg/card>

Bitte denkt dran, auch die entsprechenden Schlüssel aus dem Schlüsselbund eures Hosts zu entfernen. Damit ist der saubere Ausgangszustand wiederhergestellt.

Vorhandene Schlüssel auf die Smartcard verschieben

Bitte erstellt ein Backup des .gnupg-Verzeichnisses, denn eure privaten Schlüssel werden auf die Karte verschoben (nicht kopiert). Ihr könnt sie anschließend von der Karte nicht zurückholen.

Ich demonstriere hier, wie Beispiel-Schlüssel auf die Karte verschoben werden und werfe anschließend alles weg. Der folgende Code-Block zeigt den Vorgang:

~]$ gpg --edit-key B5248E9B6E71B11BD9B979E996E2980D6CF4189E
gpg (GnuPG) 2.4.9; Copyright (C) 2025 g10 Code GmbH
This is free software: you are free to change and redistribute it.
There is NO WARRANTY, to the extent permitted by law.

Secret key is available.

gpg: checking the trustdb
gpg: marginals needed: 3  completes needed: 1  trust model: pgp
gpg: depth: 0  valid:   2  signed:   1  trust: 0-, 0q, 0n, 0m, 0f, 2u
gpg: depth: 1  valid:   1  signed:   0  trust: 0-, 0q, 0n, 0m, 1f, 0u
gpg: next trustdb check due at 2030-06-22
sec  brainpoolP256r1/96E2980D6CF4189E
     created: 2026-10-24  expires: never       usage: SC  
     trust: ultimate      validity: ultimate
ssb  brainpoolP256r1/2403FEED88DD3FE9
     created: 2026-10-24  expires: never       usage: E   
[ultimate] (1). Kim <kim@example.com>

gpg> key 1

sec  brainpoolP256r1/96E2980D6CF4189E
     created: 2026-10-24  expires: never       usage: SC  
     trust: ultimate      validity: ultimate
ssb* brainpoolP256r1/2403FEED88DD3FE9
     created: 2026-10-24  expires: never       usage: E     
[ultimate] (1). Kim <kim@example.com>

gpg> keytocard
Please select where to store the key:
   (2) Encryption key
Your selection? 2

sec  brainpoolP256r1/96E2980D6CF4189E
     created: 2026-10-24  expires: never       usage: SC  
     trust: ultimate      validity: ultimate
ssb* brainpoolP256r1/2403FEED88DD3FE9
     created: 2026-10-24  expires: never       usage: E     
[ultimate] (1). Kim <kim@example.com>

Note: the local copy of the secret key will only be deleted with "save".
gpg> save

Ich habe zuvor lokal einen GPG-Schlüssel mit dem Algorithmus Brainpool P-256 erstellt und anschließend den Encryption Key mit keytocard in den Encryption-Slot auf der Karte verschoben. Nicht im Code-Block zu sehen ist, wie ich den Hauptschlüssel in den Signatur-Slot der Karte verschoben habe. Die privaten Schlüssel von Kim befinden sich nun auf der Karte, was sich mit gpg --card-status überprüfen lässt:

~]$ gpg --card-status
Reader ...........: Alcor Micro AU9540 00 00
Application ID ...: D27600012401030400050000DA260000
Application type .: OpenPGP
Version ..........: 3.4
Manufacturer .....: ZeitControl
Serial number ....: 0000DA26
Name of cardholder: [not set]
Language prefs ...: de
Salutation .......: 
URL of public key : [not set]
Login data .......: [not set]
Signature PIN ....: forced
Key attributes ...: brainpoolP256r1 brainpoolP256r1 rsa4096
Max. PIN lengths .: 64 64 64
PIN retry counter : 3 0 3
Signature counter : 0
KDF setting ......: off
Signature key ....: B524 8E9B 6E71 B11B D9B9  79E9 96E2 980D 6CF4 189E
      created ....: 2026-10-24 18:20:39
Encryption key....: 203F 7E4C 23A0 BB06 DB51  B3E9 2403 FEED 88DD 3FE9
      created ....: 2026-10-24 18:20:39
Authentication key: [none]
General key info..: pub  brainpoolP256r1/96E2980D6CF4189E 2026-10-24 Kim <kim@example.com>
sec>  brainpoolP256r1/96E2980D6CF4189E  created: 2026-10-24  expires: never     
                                        card-no: 0005 0000DA26
ssb>  brainpoolP256r1/2403FEED88DD3FE9  created: 2026-10-24  expires: never     
                                        card-no: 0005 0000DA26
ssb   brainpoolP256r1/5B658E197413BAE0  created: 2026-10-24  expires: never

Die Ausgabe von gpg --list-secret-keys zeigt ebenfalls durch das ‚>‘-Zeichen an, dass die privaten Schlüssel auf einer Smartcard liegen:

~]$ gpg --list-secret-keys
sec>  brainpoolP256r1 2026-10-24 [SC]
      B5248E9B6E71B11BD9B979E996E2980D6CF4189E
      Card serial no. = 0005 0000DA26
uid           [ultimate] Kim <kim@example.com>
ssb>  brainpoolP256r1 2026-10-24 [E]

Tut euch selbst einen Gefallen und prüft im Vorfeld, welche Algorithmen ihr für eure Schlüssel verwendet und welche von eurer Smartcard unterstützt werden. Versucht ihr, Schlüssel auf die Karte zu verschieben, die von der Smartcard nicht unterstützt werden, schlägt dies mit kryptischen Fehlermeldungen fehl. Diese sind so irreführend, dass ich ein Sprachmodell um Rat bitten musste, um meinem Fehler auf die Spur zu kommen. Ich hatte zuerst versucht, Schlüssel mit dem Algorithmus Curve 25519 auf die Karte zu verschieben. Dieser wird von der Karte nicht unterstützt. Die Fehlermeldung behauptete jedoch, ich hätte die Admin-PIN falsch eingegeben.

Ähnliche Erfahrungen habe ich gemacht, als ich mit dem Befehl key-attr die Einstellungen für die Key-Slots auf Parameter ändern wollte, welche von der Karte nicht unterstützt werden. Auch hier deutete die Fehlermeldung auf eine falsche Admin-PIN hin.

Fazit

Mit 22,00 Euro zzgl. Versandkosten ist die OpenPGP Smart Card V3.4 + MiFare DESFire erschwinglich, sieht schick aus und passt gut ins Portemonnaie. Darüber hinaus passt sie selbstverständlich auch gut in die Smartcard-Leser, die in vielen ThinkPad-Modellen (und ebenfalls in Business-Laptops anderer Hersteller) verbaut sind.

GnuPG-Dokumentation und -Howto sind zum Thema Smartcard alt und lückenhaft. Es bedarf eines gewissen technischen Interesses und Durchhaltewillens, um hier bis ans Ziel zu kommen. Aus meiner Sicht ist dies klar ein Nischenthema für Nerds und Menschen, die zur Nutzung dieser Technologie gezwungen sind.

Ich selbst bevorzuge, ein Offline-Backup meiner Schlüssel sicher aufzubewahren und vorhandene Schlüssel auf die Smartcard zu verschieben. Denn so kann ich meine GnuPG-Konfiguration wiederherstellen, falls die Smartcard kaputtgeht oder ich zukünftig ein Endgerät ohne Smartcard-Slot verwende.

Links zu verwandten Beiträgen

Mein inoffizieller Red Hat Errata-Monitor

Hi, in diesem Beitrag möchte ich euch ein Projekt vorstellen, an dem ich gerade arbeite. Inspiriert ist es von meinem RHEL CVE Monitor für arme Admins. Doch bevor es losgeht, beginne ich mit einem Disclaimer und einem Transparenzhinweis. Anschließend erläutere ich die Probleme, die ich mit diesem Projekt lösen möchte und gebe ein Beispiel wie man es nutzt.

Disclaimer: Es handelt sich hierbei um ein Community-Projekt, welches in keinster Weise von Red Hat stammt bzw. unterstützt wird. Es nutzt ausschließlich öffentlich verfügbare APIs, die ohne Authentifizierung genutzt werden können.

Transparenzhinweis: Das Projekt ist unter Nutzung eines KI-Coding-Assistenten entstanden.

Wofür ist das gut?

Ich führe mit meinen Kunden regelmäßig Videokonferenzen durch, um sie über Neuigkeiten zu informieren und ihre Sorgen, Nöte und Anträge aufzunehmen. Da ich ihre Red Hat-Subskriptionen kenne, möchte ich sie darüber informieren, welche Red Hat Errata seit unserem letzten Termin veröffentlicht wurden. Die Scripts aus diesem Projekt helfen mir dabei, diese Informationen effizient zusammenzustellen und in die Agenda einzufügen.

Aktuell bieten die Red Hat Errata Notifications noch keine Möglichkeit die Errata nach Produkt zu filtern. Mein Errata-Monitor bietet diese Funktionalität in Form von Filtern. Im Modus monitor speichert er auch den Status der letzten Ausführung, um bei erneuter Ausführung nur die Änderungen zum vorherigen Lauf auszugeben.

Das Projekt eignet sich damit sowohl für Ad-hoc-Abfragen, als auch für einen Monitoring-Modus, wo das Skript zeitgesteuert ausgeführt wird und neue Errata ausgibt bzw. diese Informationen per E-Mail versendet.

Wie nutzt man das?

Bitte schaut für eine ausführliche Beschreibung in das README des Projekts unter URL: https://github.com/Tronde/rh_errata_monitor. Oder nutzt die Hilfe eines der Scripte:

$ python3 rh_errata_monitor.py --help
usage: rh_errata_monitor.py [-h] [--filters FILTERS] [--state-file STATE_FILE] [--initial-days INITIAL_DAYS] [--format {json,csv,md}] [--output OUTPUT] [--exit-code]
                            [--dry-run] [--verbose]
                            {monitor,list-products,search} ...

Monitor Red Hat Errata Search API for new errata.

positional arguments:
  {monitor,list-products,search}
    monitor             Check for new errata per filter (default)
    list-products       List available product names from the API
    search              One-off stateless errata search

options:
  -h, --help            show this help message and exit
  --filters FILTERS     Path to INI filter config file (default: filters.conf)
  --state-file STATE_FILE
                        Path to JSON state file (default: .errata_state.json)
  --initial-days INITIAL_DAYS
                        On first run (no state), look back this many days (default: 30)
  --format {json,csv,md}
                        Output format (default: md)
  --output OUTPUT       Write report to file in addition to stdout
  --exit-code           Exit with code 2 when new errata are found
  --dry-run             Show queries without hitting the API
  --verbose, -v         Enable debug logging

examples:
  rh_errata_monitor.py monitor
  rh_errata_monitor.py list-products
  rh_errata_monitor.py list-products --search satellite
  rh_errata_monitor.py search --product "Red Hat Satellite" --after 2024-01-01
  rh_errata_monitor.py search --synopsis '"Ansible Automation Platform" "Setup Bundle"'
  rh_errata_monitor.py monitor --format json --output /tmp/errata.json

Die folgenden beiden Codeblöcke zeigen ein kurzes Beispiel für eine Filterdatei und einen Aufruf, den ich benutze, um eine Markdown-Ausgabe für meine Agenda zu generieren.

$ cat filter.conf 
# Red Hat Errata Monitor -- Filter Configuration
#
# Each [section] defines a named filter that the monitor checks on every run.
# Available keys:
#
#   product  = Exact product name as listed by 'list-products' command
#              Maps to: fq=portal_product_names:("...")
#
#   synopsis = Free-text search terms matched against errata synopsis/content
#              Use quotes for exact phrases: "Satellite 6" "release"
#              Maps to: q=...
#
# Both keys are optional.  If both are set, results must match BOTH (AND logic).
# If neither is set, all errata are returned (not recommended).
#
# Run 'list-products' to discover valid product names:
#   python3 rh_errata_monitor.py list-products
#   python3 rh_errata_monitor.py list-products --search satellite

# -- Red Hat Satellite -------------------------------------------------------

[satellite-releases]
# All errata for the "Red Hat Satellite" product that mention "Satellite 6"
product = Red Hat Satellite
synopsis = Satellite 6

[satellite-capsule]
product = Red Hat Satellite Capsule

# -- Red Hat Enterprise Linux ------------------------------------------------
[RHEL]
product = Red Hat Enterprise Linux for x86_64

Ich möchte also Errata für den Red Hat Satellite, Capsules und RHEL abrufen, was wie folgt aussehen kann (Ausgabe gekürzt):

$ python3 rh_errata_monitor.py search --filters filter.conf --after 2026-09-24
### satellite-releases (0 errata since 2026-09-24)

  - none

### satellite-capsule (0 errata since 2026-09-24)

  - none

### RHEL (50 errata since 2026-09-24)

  - [RHBA-2026:73791 - New Application Stream container images](https://access.redhat.com/errata/RHBA-2026:73791) - None
  - [RHSA-2026:73766 - Important: pki-core security update](https://access.redhat.com/errata/RHSA-2026:73766) - Important
  - [RHSA-2026:73765 - Important: dogtag-pki security update](https://access.redhat.com/errata/RHSA-2026:73765) - Important
  - [RHBA-2026:73746 - New Application Stream container images](https://access.redhat.com/errata/RHBA-2026:73746) - None
  - [RHEA-2026:73547 - multiple NVIDIA kernel module packages bug fix and enhancement update](https://access.redhat.com/errata/RHEA-2026:73547) - None
  - [RHEA-2026:73546 - multiple NVIDIA kernel module packages bug fix and enhancement update](https://access.redhat.com/errata/RHEA-2026:73546) - None
  - [RHSA-2026:73512 - Moderate: gawk security update](https://access.redhat.com/errata/RHSA-2026:73512) - Moderate
  - <AUSGABE GEKÜRZT>

**Total: 50 errata since 2026-09-24 across 1 filter**

Ich lasse mir hier die Errata ausgeben, die nach dem 24.09.2026 veröffentlicht wurden. Während es für den Satellite und dessen Capsules nichts neues gibt, sind 50 Errata für RHEL veröffentlicht worden. Ich habe die Ausgabe hier im Blog gekürzt, das Format ist jedoch ersichtlich.

Diese Liste kann ich nun per Copy&Paste in das Tool übernehmen, mit dem ich die Agenda für meinen TAM-Call generiere.

Wie stabil ist das Projekt?

Bei dem was ihr aktuell auf GitHub findet, handelt es sich um ein Pre-Release. Ich nutze es seit einigen Tagen und bisher hat es meinen Rechner nicht gestört.

Für die Filter nutze ich die Produktnamen aus der API und Filter die Strings aus dem Abschnitt Synopsis. Gerade letzteres ist Fehlerbehaftet und kann zu ungenauen bzw. fehlerhaften Ausgaben führen. Falls euch Fehler auffallen, freue ich mich, wenn ihr diese meldet.

Falls ihr dieses Projekt nützlich findet, lasst es mich gerne wissen. Dazu könnt ihr gern einen Kommentar unter diesem Beitrag hinterlassen oder einen Stern auf GitHub vergeben. Die CONTRIBUTING.md enthält Informationen, wie ihr darüber hinaus zum Projekt beitragen könnt.

Gelöst: Intel e1000e „Detected Hardware Unit Hang“

Dieser Post umfasst eine kurze Problembeschreibung und verweist auf die Lösung, die ich dazu im Internet gefunden und implementiert habe.

Er dient mir als Dokumentation und ich freue mich, wenn er euch ebenfalls hilft, wenn ihr von dem gleichen Problem betroffen seid.

Problembeschreibung

Ein Server mit einer Intel-Netzwerkkarte, welche den Treiber e1000e nutzt, verliert plötzlich die Netzwerkanbindung. Im Protokoll des Servers finden sich dazu wiederholt folgende Meldungen:

kernel: e1000e 0000:00:1f.6 eno1: Detected Hardware Unit Hang:

Remote-Verbindungen werden unterbrochen und es ist nur noch ein Zugriff über eine lokale Konsole möglich. Das kann unpraktisch sein, wenn sich der Server in einem hunderte Kilometer entfernten Standort befindet.

Lösung

Die Lösung habe ich bei der Internetrecherche im Blog von Ruhani Rabin gefunden: https://rabin.blog/fix-intel-e1000e-detected-hardware-unit-hang-on-proxmox/#solution-summary-proxmox-intel-e1000e-hardware-unit-hang-fix

Ruhani hat eine systemd.unit erstellt, welche die problematischen Funktionen des Treibers deaktiviert. Zusätzlich wird ein Watchdog eingerichtet, welcher helfen soll, das Problem bei erneutem Auftreten selbst zu lösen.

Bitte schaut in Ruhanis Blog-Artikel für alle Details zur Lösung. Er hat diese wirklich gut beschrieben.

Ich dokumentiere in den folgenden Code-Blöcken lediglich die systemd.units, die ich auf meinem Host implementiert habe:

# /etc/systemd/system/disable-nic-offload-eno1.service

[Unit]
Description=Disable NIC offloading for Intel e1000e interface eno1
After=network-pre.target
Wants=network-pre.target

[Service]
Type=oneshot
ExecStart=/sbin/ethtool -K eno1 gso off gro off tso off tx off rx off rxvlan off txvlan off sg off
RemainAfterExit=yes

[Install]
WantedBy=multi-user.target

Und der Watchdog:

# /etc/systemd/system/e1000e-eno1-watchdog.timer
[Unit]
Description=Run e1000e eno1 watchdog every 2 minutes

[Timer]
OnBootSec=2min
OnUnitActiveSec=2min
AccuracySec=30s
Unit=e1000e-eno1-watchdog.service

[Install]
WantedBy=timers.target

# /etc/systemd/system/e1000e-eno1-watchdog.service
[Unit]
Description=Watch for Intel e1000e hardware hangs and reset eno1
After=network-online.target

[Service]
Type=oneshot
ExecStart=/usr/local/sbin/e1000e-eno1-watchdog

Watchdog-Skript:

#!/usr/bin/env bash
set -u
set -o pipefail

IFACE="eno1"
LOOKBACK="5 minutes ago"
LOCK="/run/e1000e-${IFACE}-watchdog.lock"
STAMP="/run/e1000e-${IFACE}-last-reset"
MIN_RESET_INTERVAL_SECONDS=600

exec 9>"$LOCK"
flock -n 9 || exit 0

if ! journalctl -k --since "$LOOKBACK" --no-pager \
  | grep -Eqi "e1000e .*${IFACE}: Detected Hardware Unit Hang|Detected Hardware Unit Hang"; then
  exit 0
fi

now="$(date +%s)"
last=0
[ -f "$STAMP" ] && last="$(cat "$STAMP" 2>/dev/null || echo 0)"

if [ $((now - last)) -lt "$MIN_RESET_INTERVAL_SECONDS" ]; then
  logger -t e1000e-watchdog "hardware hang detected on ${IFACE}, but reset suppressed by rate limit"
  exit 0
fi

logger -t e1000e-watchdog "hardware hang detected on ${IFACE}; resetting NIC"

if ! ip link set "$IFACE" down; then
  logger -t e1000e-watchdog "failed to bring ${IFACE} down; NIC reset incomplete"
  exit 1
fi

sleep 2

if ! ip link set "$IFACE" up; then
  logger -t e1000e-watchdog "failed to bring ${IFACE} up; NIC reset incomplete"
  exit 1
fi

# Re-apply the offload mitigation after link reset, just in case.
ethtool -K "$IFACE" gso off gro off tso off tx off rx off rxvlan off txvlan off sg off 2>/dev/null || \
  logger -t e1000e-watchdog "warning: unable to re-apply offload mitigation on ${IFACE}"

date +%s >"$STAMP"

logger -t e1000e-watchdog "NIC reset completed for ${IFACE}"

Bugtracker

Laut des KI-Agenten meines geringsten Misstrauens ist das Problem in folgenden Trackern dokumentiert:

Zum Erscheinungsdatum dieses Beitrags befinden sich beide im Status ‚NEW‘.

Schwachstellen- und Patchmanagement im Jahre 2026

In diesem Artikel thematisiere ich, wie sich die Anzahl der entdeckten Schwachstellen in den letzten Jahren entwickelt hat und ob wir noch von Zero-Day sprechen, oder eher von Zero-Hour oder Zero-Minute.

Ich werde darstellen, warum es in meinen Augen bis auf wenige Ausnahmen nicht mehr angemessen ist, nur noch einmal im Jahr oder quartalsweise zu patchen und unter Schmerzen eingeübte Prozesse heute nicht mehr zeitgemäß erscheinen.

Anschließend werde ich euch bitten, eure Erfahrungen anonym mit mir zu teilen. Ich erhoffe mir, so einen besseren Überblick über die Situation da draußen in den Rechenzentren, Serverräumen und IT-Betriebseinheiten zu gewinnen. Mehr dazu unten im Text.

Entwicklung der Bedrohungslage

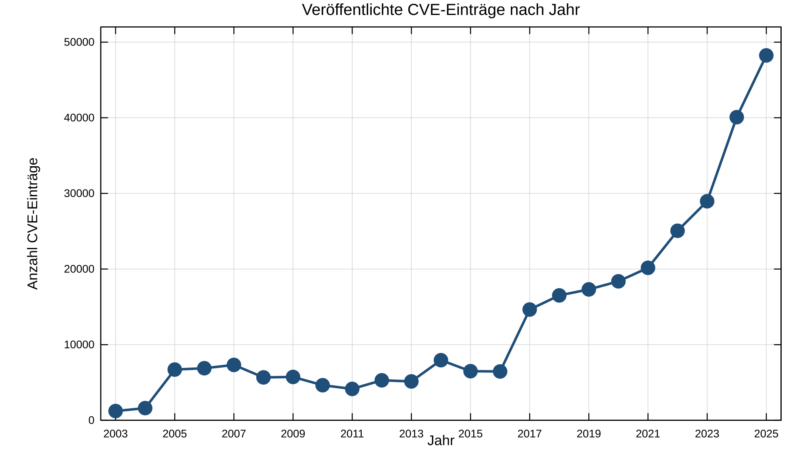
Die Anzahl der pro Jahr gemeldeten Schwachstellen (CVE) steigt rasant, wie folgendes Diagramm in Abbildung 1 verdeutlicht.

Diagramm welches die Entwicklung der Schwachstellenanzahl pro Jahr für die Jahre 2003 bis 2025 darstellt. Erläuterungen dazu finden sich im Fließtext.
Abbildung 1: Grafische Darstellung der CVE-Metriken für die Jahre 2003 bis 2025 von: https://www.cve.org/About/Metrics

Während sich die Anzahl der CVE pro Jahr erstmalig im Zeitraum von 2016 bis 2017 von ca. 6.500 auf ca. 14.500 mehr als verdoppelt hat, kam es zuletzt in den Jahren 2021 bis 2024 zu einer Verdopplung. Diesmal hat sich die Anzahl jedoch von ca. 20.000 auf knapp über 40.000 gesteigert. Und diese Zahl steigt weiter. So wurden für das erste Quartal 2026 bereits 15.176 CVE gezählt.

Wenn sich dieser Trend fortsetzt, werden wir das Jahr 2026 mit deutlich mehr als 60.000 registrierten CVE abschließen. Das wären 5.000 CVE/Monat oder 164 CVE/Tag.

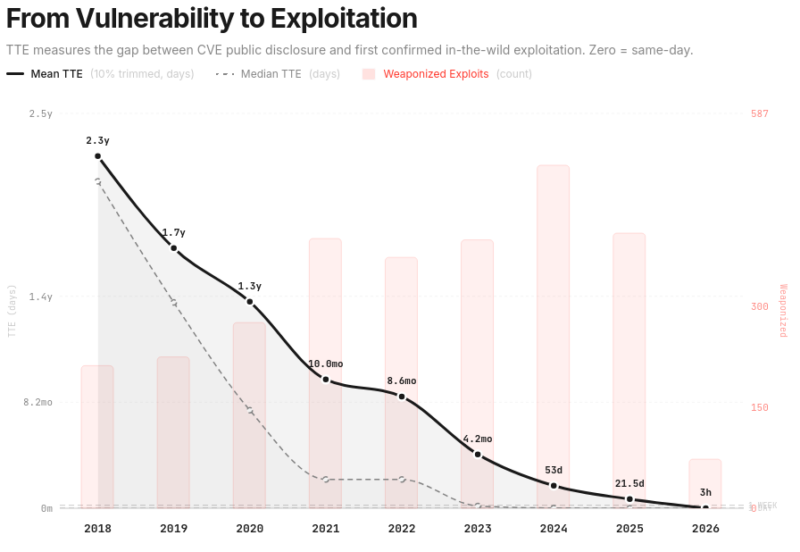
Gleichzeitig sinkt die mittlere Zeit von der Veröffentlichung eines CVE bis zu einem Exploit, wie Abbildung 2 zeigt.

Abbildung 2: Die mittlere Zeit zwischen der Veröffentlichung einer Schwachstelle und des Exploits sinkt stetig (schwarze Linie). Quelle: https://zerodayclock.com/ (letzter Abruf: 2026-06-28)

Lag die mittlere Zeit zwischen der Veröffentlichung eines CVE und des Exploits 2023 noch bei über 4 Monaten, ist diese auf 21,5 Tage im Jahr 2025 gesunken. Für 2026 wird diese sogar mit nur noch 3 Stunden angegeben.

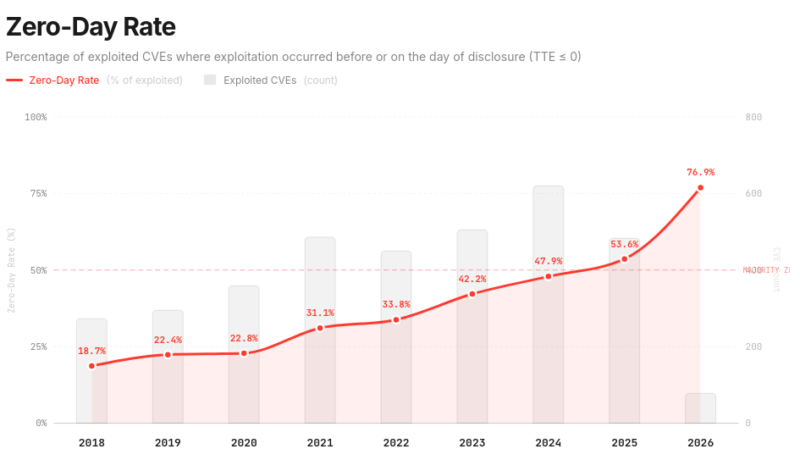
Noch bedrohlicher wirkt die Lage, wenn man sich ansieht, für wie viele CVE noch am gleichen Tag oder sogar vor deren Veröffentlichung ein Exploit bekannt wird (siehe Abbildung 3). Man spricht hier auch von Zero-Day-Exploits.

Abbildung 3: Rate der Zero-Day-Exploits, gemessen in Prozent an der Anzahl CVE pro Jahr (rote Linie). Quelle: https://zerodayclock.com/ (letzter Abruf: 2026-06-28)

Im Jahr 2024 gab es für 47,9% der CVE einen Zero-Day-Exploit. Im Jahr 2025 war das bereits für mehr als die Hälfte der Fall, nämlich 53,6 %. Das Jahr 2026 ist noch in vollem Gange. Die Rate der Zero-Day-Exploits liegt mit bisher 76,9% nochmals deutlich höher.

Es wird für die Paketbetreuenden, Upstream-Entwickelnden und Software-Herstellenden Menschen immer herausfordernder, einen Patch bereitzustellen, bevor ein Exploit existiert und aktiv gegen verwundbare Systeme eingesetzt wird.

Klassische Ansätze funktionieren nicht mehr

Aus meiner beruflichen Tätigkeit als Red Hat TAM und als Sysadministator bei verschiedenen Unternehmen ist mir bekannt, dass unterschiedliche Unternehmen und Organisationen sehr verschieden mit Schwachstellen und deren Behandlung umgehen.

Allen ist gemein, dass sie für ihre Anwendungen Wartungsfenster vereinbaren, in denen z.B. Sicherheitsaktualisierungen installiert werden, um vorhandene Schwachstellen zu schließen. Einige haben einen Patchday pro Jahr, manche patchen einmal im Quartal und wieder andere monatlich. Einzelne Unternehmen können dies sogar noch schneller.

Die einen haben regelmäßig wiederkehrende Wartungsfenster, die anderen müssen diese bei Bedarf anmelden. Einige haben schlanke Prozesse, einige nutzen Change-Management nach ITIL.

Um die Integrität, Verfügbarkeit und Vertraulichkeit der eigenen Informationssysteme und deren umgebener Infrastruktur zu schützen, sind zwei Grundsätze seit vielen Jahren allgemein bekannt:

  1. Installiere verfügbare Sicherheitsaktualisierungen so schnell wie möglich.
  2. Nutze und implementiere Verteidigung in der Tiefe.

Die beiden Grundsätze stehen nicht in einer Entweder-Oder-Beziehung. Sie sollten beide berücksichtigt werden.

In meinen Augen ist es längst nicht mehr zeitgemäß, Sicherheitsaktualisierungen jährlich oder quartalsweise zu installieren. Eine kleine Ausnahme mögen hier Systeme bilden, deren Nutzerkreis stark eingeschränkt ist und auf die ausschließlich über wenige sehr gut gesicherte Kanäle zugegriffen werden kann.

Um es deutlich zu sagen: „Für wochen- oder tagelange Change-Management-Prozesse bleibt keine Zeit. Wer weiterhin so arbeitet, riskiert die Informationssicherheit seiner Umgebung.“

Wer alle seine Systeme einmal im Monat wartet und neustartet, bewegt sich in meiner Wahrnehmung aktuell im Mittelfeld dessen, was man im Feld findet. Doch auch hierauf darf sich niemand ausruhen. Existiert zu einem CVE ein Exploit und ein Patch, erscheint es fahrlässig, bis zu einem Monat mit dessen Installation zu warten.

Leider fehlt etlichen Unternehmen bzw. Organisationen noch immer die Fähigkeit schnell festzustellen, ob ihre IT-Dienste korrekt ausgeführt werden. Patch-Management-Zyklen sehen hier meist vor, dass zuerst einige Systeme aktualisiert werden, dann wartet man 1-2 Wochen, ob jemand meckert und dann aktualisiert man die restlichen Systeme. Das ist nicht mehr zeitgemäß.

Aus der eingangs beschriebenen Bedrohungslage folgend muss das neue Ziel lauten, jedes individuelle System an jedem Tag aktualisieren und neustarten zu können. Die Funktion von IT-Diensten ist durch automatisierte Mechanismen wie z.B. Monitoring oder automatisierte Tests zu verifizieren, um schnell mit der nächsten Stage fortfahren zu können. Wer dieses Ziel noch nicht erreicht hat, sollte sich schnellstens auf den Weg machen. Selbst wenn die 100% unerreichbar scheinen, ist jedes System, das man schnell absichern kann, ein deutlich geringeres Risiko für die eigene Informationssicherheit.

Wo Sicherheitsaktualisierungen nicht zeitnah eingespielt werden können, lässt sich das Risiko durch Verteidigung in der Tiefe minimieren. Kommunikationsverbindungen von und zu betrachteten Systemen sind zu überwachen und ggf. zu limitieren. Doch auch diese Maßnahmen müssen schnell verfügbar und umsetzbar sein. Wer erst zwei Wochen diskutieren muss, ob man den Zugriff auf einen Dienst einschränken könne, müsse, sollte, handelt nicht angemessen.

Zusammenfassend sehe ich unklare Verantwortlichkeiten, langwierige Abstimmungsprozesse und manuelle Tätigkeiten als Gift und Risiko für die Informationssicherheit. Klare Strukturen, geklärte Verantwortlichkeiten und Automation sind kein nice-to-have, sondern ein MUSS.

Wie geht ihr damit um?

Nun möchte ich von euch wissen: „Patcht ihr schon oder prozessiert ihr noch?“

Ich bin sehr daran interessiert zu erfahren, wie es in den Umgebungen meiner Lesenden und derer Bekannten zugeht. Daher freue ich mich sehr, wenn ihr (gern anonym) euer Patch-Management-Konzept, die Branche eures Unternehmens und die ungefähre Größe eurer Umgebung mit der Gemeinschaft bzw. mir teilt.

  • Ihr habt euer Patch-Management im eigenen (Firmen-)Blog beschrieben? Teilt bitte den Link in den Kommentaren.
  • Sendet mir gerne eine E-Mail an patchmanagement@my-it-brain.de.
  • Beschreibt euer Patch-Management in den Kommentaren unter diesem Beitrag.

Evtl. werde ich eure Beispiele anonymisiert unter ausschließlicher Nennung der Branche (falls bekannt) in Vorträgen, Diskussion und weiteren Arbeiten zu diesem Thema verwenden. Bitte schreibt ausdrücklich dazu, wenn ihr dies nicht wünscht.

Ich freue mich auf eure Beiträge, Zusendungen und wenn ihr diesen Artikel in euren Netzwerken teilt.

Kernel Live Patching für Red Hat Enterprise Linux (RHEL)

Dieser Artikel richtet sich an jene, die sich für das Thema Kernel Live Patching (KLP) interessieren.

Im ersten Teil des Artikels stelle ich dar, wann KLP in meinen Augen keine gute Lösung darstellt und man auf den Einsatz nach Möglichkeit verzichten sollte. Wissend, dass es manchmal nicht anders geht, beschreibe ich im zweiten Teil am Beispiel von RHEL 9, wie KLP eingerichtet und genutzt werden kann.

Transparenzhinweis: Ich arbeite als Technical Account Manager (TAM) für die Firma Red Hat, welche die Distribution Red Hat Enterprise Linux (RHEL) herausgibt. Dieser Artikel spiegelt meine persönliche Meinung wider, welche mit der meines Arbeitgebers übereinstimmen kann, dies jedoch nicht in jedem Fall muss.

Der Userspace wird in diesem Artikel ausgeklammert, um den Umfang nicht zu sprengen. Ich werde diesen in einem folgenden Artikel aufgreifen.

Warum bzw. wann man Kernel Live Patching nicht nutzen sollte

Folgende Gründe sollten nicht zur Nutzung von KLP führen, sondern auf andere Weise adressiert werden:

  • Angst vor dem Serverneustart
  • Eine Softwarearchitektur, die Serverneustarts nicht vorsieht/zulässt
  • Ungeklärte Abhängigkeiten in vernetzten Systemen
  • Der Glaube, mit KLP nie wieder neustarten zu müssen

Angst ist in der IT ein ganz schlechter Ratgeber. Hier sollte unbedingt die Ursache und nicht das Symptom behandelt werden. Denn Serverneustarts können auch noch aus folgenden Gründen passieren bzw. notwendig werden:

  • Der Server verliert vorübergehend die Stromversorgung
  • Eine Kernel Panic bringt das System zum Absturz
  • Ein nicht mehr reagierendes System muss durch einen Reset neugestartet werden
  • Umzug der Hardware an einen neuen Standort

Dies sind nur vier Gründe, die mir sofort in den Sinn kommen. Wenn wir länger darüber nachdenken, fallen uns bestimmt noch viele weitere ein (ergänzt diese gern in den Kommentaren). Wichtig ist zu verstehen, dass Serverneustarts aus verschiedenen Gründen passieren und per se nicht schlimm sind.

Wenn die Softwarearchitektur keine Neustarts einzelner Komponenten zulässt, hat man ein ganz anderes Problem, welches dringend adressiert werden sollte. Soetwas wie 100%-tige Verfügbarkeit gibt es nicht. Hier ist in meinen Augen zu klären, ob es wirklich an der Anwendung oder eher an nicht verhandelten Wartungsfenstern liegt. KLP ist hier keine Lösung, da die Häufigkeit von Neustarts nur reduziert bzw. das Problem in die Zukunft verschoben wird.

Viele Sysadmins sind faul und das ist gut so. Motiviert es diese Personengruppe doch, manuelle Tätigkeiten zu automatisieren und sich die Arbeit zu erleichtern. Diese Faulheit darf allerdings nicht dazu führen, dass man sich vor der Analyse komplexer und vernetzter Systeme drückt. Abhängigkeiten können analysiert und in den meisten Fällen aufgelöst werden. Sind sie bekannt, kann man sie im Patchprozess berücksichtigen und den Vorgang inkl. Neustarts automatisieren. Auch in diesem Fall verzögert KLP das Unvermeidliche nur.

Kernel Live Patching kümmert sich, wie der Name schon sagt, nur um den Kernel. Was ist mit dem Userspace? Auch hier gibt es sicherheitskritische Bibliotheken und Anwendungen, wie z.B. openssl, gnutls oder die glibc, welche bei erkannten Schwachstellen zeitnah abgesichert werden müssen, um die Sicherheit des Systems nicht zu gefährden.

Neustarts sind per se nicht schlecht. Wer seine Server regelmäßig neustartet, gewinnt Vertrauen, dass diese auch wieder hochfahren und ihre Dienste korrekt erbringen. Schlummernde Probleme werden schneller erkannt und türmen sich nicht zu einem Störfall auf, der nur darauf wartet, im ungünstigsten Moment zu passieren. Und im Optimalfall sind die Dienste so entworfen worden, dass der Ausfall/Neustart eines einzelnen Servers nicht automatisch zu einer Nichtverfügbarkeit des Dienstes führt.

Ich möchte mein Plädoyer für Serverneustarts an dieser Stelle beenden und mich zwei Szenarios zuwenden, in denen KLP die Schmerzen des IT-Betriebs lindern kann.

Wann Kernel Live Patching Sinn macht

Für besonders geschäftskritische IT-Dienste existieren häufig Service-Level-Agreements (SLA), die eine sehr hohe Verfügbarkeit garantieren. Verstöße gegen diese SLA werden von den Stakeholdern meist nicht toleriert und sind in manchen Fällen mit Vertragsstrafen belegt. Zwar gilt auch hier, dass das Problem eher in der Softwarearchitektur liegt, doch hilft dies den Sysadmins nicht, die mit dem Betrieb beauftragt sind. Sie müssen irgendwie damit umgehen, bis eine bessere Lösung gefunden wird. Hier kann KLP eine Notlösung sein, um Sicherheitsrisiken im Betrieb zu reduzieren und SLA-Verstöße zu vermeiden.

Angelehnt an die SLA spielt die Zeit, die ein Server für einen Neustart benötigt, eine Rolle. Während die meisten VMs in Sekunden oder 1-2 Minuten neustarten, dauert dieser Vorgang bei Hardwareservern manchmal deutlich länger. Im Feld werden hier vereinzelt Zeiten zwischen 10-20 Minuten beobachtet (pro Server). Müssen mehrere Server für einen IT-Dienst sequentiell neugestartet werden, summieren sich die Zeiten schnell auf und machen größere Wartungsfenster erforderlich. KLP kann helfen, die Anzahl der langen Wartungsfenster zu reduzieren.

Es gibt Systeme, für deren Start ein manueller Eingriff durch Sysadmins notwendig ist. Dies kann z.B. die Eingabe eines BIOS-, Grub-, LUKS- oder UEFI-Passworts sein. Dies ist aufwändig und lästig, lässt sich aber leider nicht in allen Fällen wegautomatisieren. Auch hier erscheint es legitim, die Anzahl der manuellen Eingriffe durch den Einsatz von KLP zu minimieren.

Kernel Live Patching für RHEL 9 konfigurieren

Um mich für die Konfiguration vorzubereiten, habe ich folgende drei Quellen studiert:

Die wichtigsten Erkenntnisse daraus sind für mich:

  • Nicht jeder RHEL-Kernel erhält Live-Patches
  • An jedem 1. März, Juni, September und Dezember (jedes Quartal) wird für jedes unterstützte RHEL-Release ein Kernel festgelegt, welcher Live-Patches erhält
  • Für jeden dieser Kernel verspricht Red Hat bis zu einem Jahr lang Updates für CVEs, die nach Red Hats Ermessen als critical oder important kategorisiert wurden (siehe Severity Ratings)

Dass Red Hat für ausgewählte Kernel-Releases ein Jahr lang Live-Patches bereitstellt, lässt nicht den Schluss zu, nur noch einmal pro Jahr neustarten zu müssen. Denn:

  • CVEs der Kategorien moderate und low werden gar nicht adressiert
  • Man erhält keinerlei Bugfixes und keinerlei Produktverbesserungen (Red Hat Enhancement Advisories (RHEA))

Die Planung eines Neustarts wird jedoch ggf. vereinfacht.

Konfiguration von Kernel Live Patching für ein Labor-System

Ich habe ein Labor-System mit RHEL 9 auserkoren, welches als Hypervisor für einige Libvirt/KVM-VMs genutzt wird.

Dieses läuft aktuell mit dem Kernel 5.14.0-687.15.1.el9_8.x86_64, welcher laut Kernel Live Patch life cycles kein Kernel ist, für den KLP angeboten wird. Es ist also zuerst der kernel-5.14.0-687.10.1 zu installieren. Anschließend folge ich der Dokumentation, um den Live-Patch-Stream für diesen Kernel zu aktivieren (siehe folgender Codeblock).

~]$ sudo dnf search kernel-5.14.0-687.10.1.el9_8
Updating Subscription Management repositories.
Last metadata expiration check: 0:04:34 ago on Tue 23 Jun 2026 11:31:09 AM CEST.
================ Summary Matched: kernel-5.14.0-687.10.1.el9_8 ================
kpatch-patch-5_14_0-687_10_1.x86_64 : Initial empty kpatch-patch for
                                    : kernel-5.14.0-687.10.1.el9_8.x86_64
~]$ sudo dnf install kpatch-patch-5_14_0-687_10_1.x86_64

Wie im obigen Codeblock zu sehen, handelt es sich dabei um den initialen und leeren kpatch-patch. Das System hat also noch keinen Fix erhalten, sondern ist lediglich darauf vorbereitet.

Im jetzigen Zustand würde DNF das System bei einem Update jedoch auf die letzte verfügbare Kernelversion aktualisieren, welche keine Live-Patches erhält. Da dies von mir nicht gewünscht ist, aktiviere ich einen Filter, der zukünftig nur noch KLP-fähige Kernel anzeigt. Der folgende Codeblock zeigt den Zustand vor der Aktivierung des Filters, die Aktivierung selbst und den Zustand danach.

~]$ sudo dnf kpatch status
Updating Subscription Management repositories.
Last metadata expiration check: 0:04:36 ago on Tue 23 Jun 2026 11:43:44 AM CEST.
Kpatch update setting: auto-update
Kpatch filter setting: no-filter
Dependencies resolved.
Nothing to do.
Complete!

~]$ sudo dnf kpatch auto-filter
Updating Subscription Management repositories.
Kpatch filter setting: auto-filter

~]$ sudo dnf kpatch status
Please note, kpatch filter is enabled, only kpatch supported kernels are shown.
Kpatch update setting: auto-update
Kpatch filter setting: auto-filter
Dependencies resolved.
Nothing to do.
Complete!

Zum Abschluss ein Neustart und mein System läuft mit dem richtigen Kernel 5.14.0-687.10.1.el9_8.x86_64.

Aufräumarbeiten

Aktuell sind auf meinem System noch Kernel-Pakete installiert, die für KLP nicht vorgesehen sind, aber bei einem dnf update aktualisiert werden würden:

~]# dnf list --installed kernel*
Updating Subscription Management repositories.
Please note, kpatch filter is enabled, only kpatch supported kernels are shown.
Installed Packages
kernel.x86_64              5.14.0-611.55.1.el9_7 @rhel-9-for-x86_64-baseos-rpms
kernel.x86_64              5.14.0-687.10.1.el9_8 @rhel-9-for-x86_64-baseos-rpms
kernel.x86_64              5.14.0-687.15.1.el9_8 @rhel-9-for-x86_64-baseos-rpms
kernel-core.x86_64         5.14.0-611.55.1.el9_7 @rhel-9-for-x86_64-baseos-rpms
kernel-core.x86_64         5.14.0-687.10.1.el9_8 @rhel-9-for-x86_64-baseos-rpms
kernel-core.x86_64         5.14.0-687.15.1.el9_8 @rhel-9-for-x86_64-baseos-rpms
kernel-devel.x86_64        5.14.0-611.38.1.el9_7 @rhel-9-for-x86_64-appstream-rpms
kernel-devel.x86_64        5.14.0-611.55.1.el9_7 @rhel-9-for-x86_64-appstream-rpms
kernel-devel.x86_64        5.14.0-687.15.1.el9_8 @rhel-9-for-x86_64-appstream-rpms
kernel-headers.x86_64      5.14.0-687.15.1.el9_8 @rhel-9-for-x86_64-appstream-rpms
kernel-modules.x86_64      5.14.0-611.55.1.el9_7 @rhel-9-for-x86_64-baseos-rpms
kernel-modules.x86_64      5.14.0-687.10.1.el9_8 @rhel-9-for-x86_64-baseos-rpms
kernel-modules.x86_64      5.14.0-687.15.1.el9_8 @rhel-9-for-x86_64-baseos-rpms
kernel-modules-core.x86_64 5.14.0-611.55.1.el9_7 @rhel-9-for-x86_64-baseos-rpms
kernel-modules-core.x86_64 5.14.0-687.10.1.el9_8 @rhel-9-for-x86_64-baseos-rpms
kernel-modules-core.x86_64 5.14.0-687.15.1.el9_8 @rhel-9-for-x86_64-baseos-rpms
kernel-tools.x86_64        5.14.0-687.15.1.el9_8 @rhel-9-for-x86_64-baseos-rpms
kernel-tools-libs.x86_64   5.14.0-687.15.1.el9_8 @rhel-9-for-x86_64-baseos-rpms

Um aufzuräumen, habe ich alle überflüssigen Pakte entfernt, bis nur noch der KLP-fähige Kernel vorhanden ist:

~]# dnf list --installed kernel*
Updating Subscription Management repositories.
Please note, kpatch filter is enabled, only kpatch supported kernels are shown.
Installed Packages
kernel.x86_64                5.14.0-687.10.1.el9_8   @rhel-9-for-x86_64-baseos-rpms
kernel-core.x86_64           5.14.0-687.10.1.el9_8   @rhel-9-for-x86_64-baseos-rpms
kernel-modules.x86_64        5.14.0-687.10.1.el9_8   @rhel-9-for-x86_64-baseos-rpms
kernel-modules-core.x86_64   5.14.0-687.10.1.el9_8   @rhel-9-for-x86_64-baseos-rpms

Verhalten bei zukünftigen Updates

Durch den konfigurierten kpatch-Filter werden bei zukünftigen Updates nur Kernel aufgeführt, die KLP-fähig sind. Wird ein KLP veröffentlicht, erscheint dieser als kpatch-patch in der Ausgabe von dnf up`. Der folgende (gekürzte) Codeblock zeigt dies beispielhaft.

~]# dnf up
Updating Subscription Management repositories.
Please note, kpatch filter is enabled, only kpatch supported kernels are shown.
Dependencies resolved.
===================================================================================
 Package       Arch   Version               Repository                        Size
===================================================================================
Upgrading:
…
kpatch-patch-5_14_0-687_10_1 x86_64 1-1.el9_8 rhel-9-for-x86_64-baseos-rpms   22 k
…

Mit dem Befehl aus dem nächsten Codeblock kann kontrolliert werden, welche KLP aktuell installiert sind und welche CVEs sie adressieren.

~]# kpatch list
Loaded patch modules:
kpatch_5_14_0_687_10_1_1_1 [enabled]
	CVE-2026-43037

Installed patch modules:
kpatch_5_14_0_687_10_1_1_1 (5.14.0-687.10.1.el9_8.x86_64)

Obige Ausgabe bestätigt, dass ein KLP aktiv ist, der die kritische Schwachstelle CVE-2026-43037 schließt.

Fazit

KLP funktioniert und ist einfach einzurichten. Es ist nicht in jedem Fall die richtige Lösung und löst nicht alle Probleme, kann jedoch in manchen Fällen die Schmerzen im IT-Betrieb lindern.

Der Userspace wurde ausgeklammert, um den Umfang dieses Artikels nicht zu sprengen. Dies hebe ich mir für einen folgenden Artikel auf.

2. Erfahrungsbericht zum Reise-Router GL.iNet GL-A1300 mit OpenWrt und Travelmate

Ein Wohnmobil, drei Reisende, vier Tage und fünf internetfähige Geräte (von denen wir wissen). Diese bilden den Rahmen für den zweiten Erfahrungsbericht zu meinem Reise-Router GL.iNet GL-A1300 mit OpenWrt und Travelmate.

Nach unserem Kurzurlaub habe ich meine Frau gefragt, ob sie den kleinen Reise-Router nützlich fand. Die Antwort war ein klares Ja. Es hat ihr gefallen, dass wir den kleinen Router nur mit einem USB-Anschluss versorgen und mit einem Uplink verbinden mussten und alle unsere internetfähigen Geräte waren ohne weitere Konfiguration wieder online. Das freut mich sehr, denn genau dies war der erhoffte Effekt.

Mir ist aufgefallen, dass ich das LuCI-Webinterface nicht mit den Webbrowsern meines Android-Smartphones aufrufen kann, mit denen meines Android-Tablets aber schon. Ich nutze auf beiden Firefox und Firefox Klar. Falls jemand eine Erklärung, für dieses Mysterium hat, freue ich mich über einen Kommentar.

AdBlock Fast klemmte zu Beginn. Ein apk update gefolgt von einem apk upgrade auf der CLI löste das Problem jedoch schnell in Luft auf.

An Plätzen, an denen kein Uplink-WLAN verfügbar war, habe ich den mobilen Hostspot meines Smartphones als Uplink benutzt. Auch dies hat gut funktioniert. Da sich das Smartphone meist in meiner Hosentasche befindet, habe ich mich einige Male damit aus der Reichtweite des Reise-Routers entfernt. Dramatisch war auch dies nicht, wurde jedoch umgehend durch humanoide Überwachungssysteme angezeigt. ;-)

Natürlich hat GL.iNet mit dem Mudi 7 (GL-E5800) auch für dieses Luxusproblem eine Lösung im Angebot. Allerdings sind mir die ca. 425 Euro für diesen Luxus etwas zu viel. Kennt ihr Alternativen, die über ähnliche Funktionen verfügen? Also klein, kompakt und fähig eine SIM-Karte zu tragen? Dann teilt diese doch bitte in den Kommentaren.

Der Reise-Router hat sich während einer Dienstreise und einer viertägigen Urlaubsreise bewährt und wird uns bzw. mich auch zukünftig auf diesen Reisen begleiten.

Vorstellung von 2,5 großartigen Open-Source-Projekten

Getreu dem Motto „Nutze Gutes und schreibe darüber“ stelle ich im heutigen Beitrag die Open-Source-Projekte lab-toolbox, kcli und kcli-toolbox vor.

Lab-toolbox

Die lab-toolbox ist ein Projekt von meinem TAM-Kollegen Chris Huang. Es handelt sich dabei um ein Python-Skript, welches die Erstellung von virtuellen Maschinen (VM) mit Red Hat Enterprise Linux (RHEL) unter KVM/QUEMU vereinfacht und beschleunigt.

Hinter der Idee zu diesem Projekt steckt dieser Anwendungsfall:

Als Plattform-TAMs müssen wir regelmäßig Dinge unter verschiedenen RHEL-Versionen testen. Häufig muss hierzu eine frische VM auf unserem Laptop herhalten, die nach dem Test auch direkt wieder entsorgt werden kann. Dies kann nun bspw. mit dem folgenden Kommando erledigt werden:

./create_vm.py --rhel 10 --hostname rhel10-1 --memory 4096 --vcpus 2

Mit diesem einen Befehl werden folgende Aufgaben ausgeführt:

  1. Es wird das aktuelle RHEL 10 Image auf der lokalen Festplatte genutzt, um eine RHEL 10 VM mit 4 GB RAM und 2 vCPU zu erstellen
  2. Das Skript fragt nach einem Passwort für den Konsolen-Login oder bietet an, sich ausschließlich per SSH einzuloggen
  3. Es generiert automatisch die Konfiguration für cloud-init, um:
    • den aktuellen Benutzer innerhalb der neuen VM zu erstellen
    • den SSH-Public-Key des Benutzers hinzuzufügen (automatisch oder per Option)

Ist die VM erstellt, können wir uns direkt mit unserem Benutzer und dessen SSH-Schlüssel einloggen.

Es gibt im Internet viele Wrapper-Skripte, welche die Einrichtung von lokalen VMs vereinfachen sollen. Mir gefällt an diesem besonders, dass es einen meiner häufigsten Anwendungsfälle auf den Punkt bedient. Dazu gibt es ein ausführliches README.md mit einer ausführlichen Dokumentation und einigen Beispielen.

Danke Chris, dass du dieses tolle Projekt mit uns teilst.

Kcli

Wenn es ein bischen mehr sein darf und z.B. folgende Funktionen gewünscht sind:

  • Deplyoment von Cloud-Images bei verschiedenen Providern (z.B. libvirt, KubeVirt, oVirt, OpenStack, VMware vSphere, AWS, Azure, GCP, IBM cloud and Hcloud) mit einem einzigen Werkzeug
  • Profile, um VMs mit der gleichen Hardware-Charakteristik zu starten
  • Komplette Labor-Umgebungen in YAML deklarieren und ausrollen
  • Große Auswahl an Cloud-Images verschiedener Linux-Distributionen
  • Einfache Verteilung und Integration von SSH-Schlüsseln
  • Automatische Registrierung von RHEL-VMs

Dann ist das Projekt kcli von meinem Kollegen Karim Boumedhel und vielen weiteren Beitragenden vielleicht etwas für euch. Wenn ihr jetzt neugierig geworden seid, werft für weitere Informationen einen Blick in die Dokumentation.

Als TAM und Sysadmin möchte ich auch komplexe Systeme testen, welche häufig aus mehreren VMs bestehen. Da mein Laptop hier schnell an seine Grenzen stößt, möchte ich diese Laborumgebungen auch bei anderen Anbietern bereitstellen können. Hierfür scheint mir dieses Projekt gut geeignet zu sein.

Kcli-toolbox

Dies ist der 0,5-Anteil der Vorstellungen in diesem Artikel. Damit ist nicht gemeint, dass es erst zur Hälfte fertig ist. Es ist vielmehr kein richtiges Projekt, sondern lediglich ein Containerfile und ein Custom-Toolbox-Build.

Toolbx ist ein Werkzeug für Linux, welches ein CLI für Softwareentwicklung und Troubleshooting bereitstellt, ohne dass ihr dafür alle notwendigen Werkzeuge auf eurem Host-System installieren müsst. Eine Toolbox basiert auf einem OCI-Container-Image. Es gibt sie in verschiedenen Geschmacksrichtungen. Bitte schaut für weitere Informationen in die Dokumentation.

Bei kcli-toolbox handelt es sich um ein Toolbox-Container-Image, bei dem kcli schon vorinstalliert ist. Das Image wird jeden Dienstag um 03:42 Uhr Ortszeit neu gebaut, um es auf einem aktuellen Stand zu halten.

Mir enthält der Abschnitt „Container Install“ der kcli-Dokumentation zu viele Optionen und aliases, die ich mir nicht merken möchte. Die Builds für EPEL-9 schlagen seit einiger Zeit fehl, so dass ich unter RHEL 9 nicht die letzte Version als RPM nutzen kann. Daher kam mir die Idee zu kcli-toolbox. Ich habe hiermit die aktuellste Version für Fedora 44 und kann diese so natürlich nutzen, als wäre sie als RPM-Paket installiert.

Probiert es doch gerne selbst einmal aus. Hinweise dazu findet ihr in der README.md.

Versteckte CLI-Optionen in Open-Source-Projekten: Fluch oder Segen?

Transparenzhinweis: Der Entwurf dieses Artikels wurde mithilfe der Mistral-KI Le Chat erstellt und von mir redigiert.

Versteckte CLI-Optionen: Warum Entwickler sie nutzen – und warum das umstritten ist

In der Welt der Open-Source-Software gibt es eine Praxis, die immer wieder für Diskussionen sorgt: das Verstecken von CLI-Optionen (Command Line Interface). Diese Optionen sind oft nicht in der offiziellen Dokumentation aufgeführt, werden aber dennoch im Code implementiert – sei es für Debugging-Zwecke, als Notlösung für spezielle Anwendungsfälle oder als „Geheimtipp“ für erfahrene Nutzer.

Ein Beispiel ist der Commit im xfsprogs-Projekt, der die Erstellung von XFS-Dateisystemen kleiner als 300 MB standardmäßig blockiert. Gleichzeitig wurde eine undokumentierte Option (--unsupported) eingeführt, um diese Beschränkung zu umgehen – allerdings ohne Hinweis in der Manpage mkfs.xfs(8) oder Hilfeausgabe.

Doch warum tun Entwickler das? Und welche Vor- und Nachteile hat diese Praxis für Nutzer, Maintainer und die Community?


Warum versteckte CLI-Optionen existieren

1. Flexibilität für Entwickler und Tester

  • Debugging & Testing: Versteckte Optionen ermöglichen es Entwicklern, spezielle Testumgebungen zu simulieren oder Fehler zu reproduzieren, ohne die Stabilität der Software für Endnutzer zu gefährden.
  • Beispiel: Im xfsprogs-Commit wird die 300-MB-Beschränkung für automatisierte Tests (fstests) deaktiviert, wenn bestimmte Umgebungsvariablen gesetzt sind. Das verhindert, dass Hunderte von Tests angepasst werden müssen.

2. Schnelle Lösungen für Nischenprobleme

  • Manchmal gibt es seltene Anwendungsfälle, die so selten sind, dass eine offizielle Unterstützung nicht sinnvoll erscheint.
  • Beispiel: Die Option --unsupported für mkfs.xfs, da diese im Normalbetrieb gefährliche Folgen, wie den Verlust von Leistung und Redundanz, haben können.

3. Vermeidung von Missbrauch

  • Manche Optionen sind potenziell gefährlich (z. B. das Umgehen von Sicherheitsprüfungen). Durch das Verstecken sollen nur Nutzer mit entsprechendem Wissen darauf zugreifen.

Die Kehrseite der Medaille: Warum versteckte Optionen problematisch sind

1. Mangelnde Transparenz

  • Open Source lebt von Transparenz und Gemeinschaft. Versteckte Optionen widersprechen diesem Prinzip: Nutzer wissen nicht, welche Möglichkeiten es gibt, und können die Software nicht voll ausschöpfen und damit nicht uneingeschränkt nutzen.
  • Frage: Wenn eine Option (nur in seltenen Ausnahmefällen) nützlich ist, warum sollte sie nicht dokumentiert werden?

2. Wartungsaufwand und „Technical Debt“

  • Undokumentierte Features werden schnell zu „Technical Debt“: Neue Entwickler kennen sie nicht, Nutzer stoßen zufällig darauf und die Optionen werden nie offiziell unterstützt, obwohl sie vielleicht weit verbreitet sind.
  • Beispiel: Im Linux-Kernel gibt es zahlreiche obskure Kernel-Parameter, die nur in Mailinglisten oder alten Foren erwähnt werden.

3. Frustration für Nutzer

  • Nutzer, die auf ein Problem stoßen, finden keine Lösung in der Dokumentation, obwohl diese vielleicht existiert. Das führt zu unnötigen Support-Anfragen oder Workarounds.
  • Beispiel: „Für eigene Tests möchte ich XFS-Dateisysteme kleiner 300 MB erstellen. Bis ich die Option --unsupported im Quelltext gefunden habe, war mir dies nicht möglich, ohne eine veraltete Version von xfsprogs zu nutzen.“

Deine Meinung zählt: Sollten versteckte CLI-Optionen abgeschafft werden?

Die Diskussion um versteckte Optionen ist auch eine Frage der Philosophie: Sollte Open-Source-Software maximale Freiheit bieten – auch auf Kosten von Komplexität? Oder sollte sie benutzerfreundlich sein und nur offizielle, getestete Features anbieten?

Was denkst du?

  • Hast du schon einmal von einer versteckten CLI-Option profitiert oder dich über das Fehlen einer Dokumentation geärgert?
  • Sollten Projekte wie xfsprogs alle Optionen offenlegen, selbst wenn sie offiziell nicht unterstützt und im IT-Betrieb gefährlich sind?
  • Oder ist es in Ordnung, wenn Entwickler „Hintertüren“ für spezielle Fälle einbauen?

Teile deine Erfahrung in den Kommentaren!

Erfahrungsbericht: Reise-Router GL.iNet GL-A1300 mit OpenWrt

In diesem Artikel erfahrt ihr, warum ich einen Reise-Router haben möchte, welchen ich aktuell mit welcher Firmware und zusätzlichen Paketen nutze und wie zufrieden ich damit bin.

Ich erhalte weder vom Hardwarehersteller noch von den verwendeten Projekten Zuwendungen irgendwelcher Art für diesen Bericht. Er gibt ausschließlich meine persönliche Meinung wieder.

Motivation

Wir sind eine kleine Familie mit einer ganzen Menge an WLAN-Geräten. Diese Geräte begleiten uns zu Hause wie unterwegs.

Daheim kümmerten sich in der Vergangenheit Pi-hole und heute OPNsense darum, dass wir von Werbung auf unseren Geräten so gut es geht verschont bleiben.

Erst, wenn wir unterwegs sind und z.B. Hotel-WLAN oder öffentliche Hotspots nutzen, fällt uns auf, wie kaputt das Internet eigentlich ist. Unser Kind findet vor lauter Werbung die Spiele auf dem Tablet nicht wieder und der übermäßige Werbemüll vermiest uns jeden Medienkonsum.

Ich habe keine Lust, jedes Gerät einzeln zu konfigurieren, um der Werbeindustrie Widerstand zu leisten. Daher möchte ich einen Reise-Router zu Hilfe nehmen. Die Idee ist, dass ich einen kleinen Router mit dem Hotel-WLAN verbinde, welcher dann für unsere Geräte ein WLAN aufspannt. Dieser Router stellt Dienste wie DHCP, DNS und einen Werbeblocker bereit, welche von allen verbundenen Geräten genutzt werden können.

Zusätzlich lässt sich mit dem Reise-Router auch die Einschränkung in manchen Hotels umgehen, wo sich nur ein einziges Gerät mit den bereitgestellten Zugangsdaten gleichzeitig mit dem Hotel-WLAN verbinden darf.

Dies kommt mir auch beruflich zugute, wo ich meist mit Handy und Laptop reise. So kann ich meine Geräte durch die im Reise-Router integrierte Firewall zusätzlich schützen. Ich kann sogar eine kleine, mobile Laborumgebung mithilfe des Routers aufbauen.

Slate Plus (GL-A1300)

Ich habe auf Mastodon um Empfehlungen gebeten und mit Kollegen gesprochen. Danke euch allen für eure Unterstützung. Am Ende habe ich mich für den Slate Plus (GL-A1300) von GL.iNet entschieden:

Erworben habe ich diesen bei einem großen Online-Gemischtwarenhändler für 76,99 Euro. Anschließend habe ich OpenWrt 24.10.5 via SSH darauf installiert. Das OpenWrt-Projekt ist ein Linux-Betriebssystem für eingebettete Systeme, wie den hier genannten GL-A1300.

Um OpenWrt auf einem Router zu installieren, sind fortgeschrittene Kenntnisse im Bereich der Systemadministration erforderlich. Es besteht trotz guter Software und Dokumentation die Gefahr, dass man sein Gerät bei diesem Vorgang unbrauchbar macht (bricked). Ich beschreibe die Installation hier nicht im Einzelnen und verweise auf das OpenWrt Wiki.

Travelmate, ein Verbindungsmanager für Reise-Router

Travelmate läuft auf OpenWrt und stellt eine Verbindung (Uplink) zum WLAN-Zugangspunkt/Hotspot z.B. des Hotels, der Ferienunterkunft her. Travelmate wird dann zum Zugangspunkt (Access Point) für unsere Geräte und bietet uns einen sicheren Zugang zum Internet.

Travelmate verwaltet alle Netzwerkeinstellungen, Firewall-Einstellungen, Verbindungen zum WLAN usw. und stellt automatisch eine (erneute) Verbindung zu konfigurierten APs/Hotspots her, sobald diese verfügbar sind.

Hilfe zur Installation und Konfiguration bietet die Travelmate-Seite im OpenWrt Wiki. Nach der Installation habe ich Travelmate genutzt, um meinen Reise-Router mit meinem WLAN zu Hause zu verbinden. Dies geht genauso einfach, wie einen Laptop in das WLAN zu integrieren.

Während ich die Zeilen für diesen Abschnitt schreibe, bin ich mit meinem Laptop mit dem WLAN des GL-A1300 verbunden, welcher über mein Heim-WLAN mit dem Internet verbunden ist. Das folgende Bild dient der Veranschaulichung des Testaufbaus:

Das Bild zeigt von links nach rechts die Symbole für einen Laptop, einen WLAN-Router der den Reise-Router GL-A1300 repräsentiert, ein WLAN-Symbol für das Heimnetzwerk, eine Firewall und ein Symbol für das Internet.
Testaufbau mit dem Reise-Router GL-A1300

AdBlock-Fast

AdBlock-Fast ist ein leistungsstarker Werbeblocker-Dienst für OpenWrt, der sich in Dnsmasq, SmartDNS und Unbound integrieren lässt. Er unterstützt das parallele Herunterladen und Verarbeiten von Remote-Block- und Allow-Listen und optimiert diese in effiziente, mit Resolvern kompatible Formate.

Die Installation verlief wie beschrieben. Ich habe wahllos einige Block-Listen heruntergeladen und aktiviert. Einen Test werde ich auf meiner nächsten Dienstreise durchführen.

Erster Einsatz im Hotel

Der erste Praxistest erfolgte auf Dienstreise im Hotel.

Im Hotelzimmer wird der Reise-Router über ein USB-C-Kabel und ein Standards-USB-Ladegerät mit Strom versorgt. Ich starte meinen Laptop und verbinde mich mit dem WLAN des Reise-Routers. Anschließend öffne ich das Webinterface des Reise-Routers in meinem Webbrowser. Die Standards-IP-Adresse von OpenWrt lautet 192.168.1.1. Unter Services/Travelmate/Wireless Stations scanne ich nach verfügbaren Netzwerken und stelle eine Verbindung zum offenen Hotel-WLAN her.

Das Hotel bietet ein offenes WLAN ohne Authentifizierung an. Um in das Internet zu gelangen, muss man jedoch zuerst die Nutzungsbedingungen auf einer Portalseite bestätigen. Dies erledige ich über mein Telefon, welches ich mit dem WLAN des Reise-Routers verbinde. Die Bestätigungsseite wird hier einmalig angezeigt. Alle weiteren Geräte können das Internet nutzen, ohne dies nochmals separat bestätigen zu müssen. Denn aus Sicht des Hotel-WLANs ist nur ein WLAN-Client verbunden.

Um den AdBlocker zu testen, habe ich eine Runde in meiner Skat-App gespielt. Ohne AdBlocker sieht man hier sein Blatt vor lauter Werbung nicht. Auch hier funktioniert alles wie gewünscht.

Fazit

Einzig die Firmware auf die Hardware zu flashen erfordert fortgeschrittene Kenntnisse. Die anschließende Nutzung des Reise-Routers ist unkompliziert.

Die Stromversorgung über USB macht das Gerät einfach und flexibel einsetzbar. Die Verbindungsqualität ist gut und der Werbeblocker arbeitet wie erwartet. Evtl. werde ich noch das Wireguard-VPN testen. Dies könnte nützlich sein, um mich zu meinem Heimlabor zu verbinden.

Als nächstes werde ich alle unsere WLAN-Gräte für die Nutzung des Reise-Routers konfigurieren, so dass wir das nicht unterwegs tun müssen.

Von scrartcl zu typst

In der Vergangenheit habe ich viele Dokumente, wie z.B. Hausarbeiten, Aufsätze, Briefe, Dokumentationen und Präsentationen mit LaTeX erstellt. In der Vorbereitungsphase für einen Vortrag haben Dirk und ich beschlossen, Typst zu lernen.

Wie ich Briefe mit Typst statt LaTeX schreibe, habe ich bereits beschrieben. Hier schreibe ich, wie ich meine Notfalldokumentation von scrartcl zu typst migriert habe.

Ich habe kein Werkzeug zur automatischen Konvertierung genutzt, da ich zu faul war, ein solches erst zu finden und zu erlernen. Stattdessen habe ich Vim genutzt und die entsprechenden Umgebungen ersetzt. Das war in diesem Fall in Ordnung, kann aber bei komplexeren Dokumenten schnell in Arbeit ausarten. Allerdings werden Automaten bei zunehmend komplexen Projekten ebenfalls an ihre Grenzen kommen.

Im Folgenden findet ihr einen kurzen Vergleich der Syntax-Elemente.

Die Preamble (Vorspann)

Die Preamble ist der Teil des LaTeX-Dokuments, der vor dem eigentlichen Inhalt steht. Hier werden grundlegende Einstellungen und Pakete definiert, die während der Dokumenterstellung verwendet werden. Die Preamble beginnt immer mit dem Befehl \documentclass und endet mit dem Befehl \begin{document}.

Quelle: https://www.namsu.de/LaTeX-Buch/kap2-2.html

Die LaTeX-Preamble meiner Dokumentation sieht wie folgt aus:

\documentclass[a4paper,parskip=half,numbers=noenddot]{scrartcl}
\usepackage[ngerman]{babel}
\usepackage[T1]{fontenc}
\usepackage[utf8x]{inputenc}
\usepackage{lmodern}
\usepackage{graphicx}
\usepackage{subcaption}
\usepackage[ngerman]{varioref}
\usepackage{pdfpages}
\usepackage{hyperref}

%opening
\title{Dokumentation des Heimnetzwerks in der Triftenstr. 10}
\author{Jörg Kastning}

\begin{document}

Der Vorspann meiner typ-Datei zum Vergleich:

#set page(paper: "a4", numbering: "1")
#set heading(numbering: "1.1")
#set text(lang: "de")
#set document(
  title: [Dokumentation des Heimnetzwerks in der Triftenstr. 10],
  author: "Jörg Kastning"
)

Die Syntax-Elemente werden in der Typst-Referenz erklärt, z.B.:

Die Referenz ist ständig in einem Browser-Tab geöffnet, wenn ich mit typst arbeite. Dies wird so bleiben, bis ich die am häufigsten verwendeten Funktionen auswendig kenne.

Grundsätzlich halte ich mich an das KISS-Prinzip und den Grundsatz: Form follows function (Deutsch: die Form folgt der Funktion bzw. dem Inhalt). Ich möchte mich so viel wie möglich mit dem Inhalt beschäftigen und möglichst wenig Zeit mit dem Satz bzw. der Formatierung zubringen.

Abbildungen und Tabellen

Zu den häufigsten Umgebungen zählen vermutlich Abbildungen und Tabellen. In der LaTeX-Version habe ich diese wie folgt gesetzt:

\begin{tabular}{ll}
    Vertragsnummer  & 12345\\
    Kundennummer  & 98765432\\
    Tarif & zuhause100\\
\end{tabular}

\begin{figure}
    \centering
    \includegraphics[scale=0.3]{bilder/bild.jpg}
    \caption{Meine super Bildunterschrift}
    \label{fig:bild}
\end{figure}

\begin{figure}
    \begin{subfigure}[c]{0.5\textwidth}
        \includegraphics[width=0.9\textwidth]{bilder/front.jpg}
        \subcaption{Frontansicht}
    \end{subfigure}
    \begin{subfigure}[c]{0.5\textwidth}
        \includegraphics[width=0.9\textwidth]{bilder/rear.jpg}
        \subcaption{Rückansicht}
    \end{subfigure}
    \caption{Das sind zwei tolle Abbildungen.}
    \label{fig:bild2}
\end{figure}

Für das LaTeX-Konstrukt subfigure habe ich keinen entsprechenden Ersatz in typst gefunden. Ich setze dies in einzelnen Abbildungen hintereinander um. Die Umgebungen sehen nun wie folgt aus:

#figure(
  table(
    columns: 2,
    stroke: (x: none),
    [Vertragsnummer], [12345],
    [Kundennummer], [98765432],
    [Tarif], [zuhause100],
  ),
  caption: [Vertragsinformationen],
) <referenz-name>

#figure(
  image("bilder/bild.jpg", width: 30%),
  caption: [Meine super Bildunterschrift],
) <referenz_name2>

Tabellen und Bilder werden beide in einer figure-Umgebung gesetzt. Dies macht in meinen Augen Sinn, da beide Umgebungen in der Regel mit einer Über- bzw. Unterschrift versehen werden, häufig zentriert gesetzt und mit einer Referenz versehen werden.

Ich habe mich noch nicht ganz an die Terminologie gewöhnt. Typst bezeichnet figure und table sowie die meisten anderen Elemente als Funktionen und nicht als Umgebungen.

Aufzählungen, Links und Listen

Für nummerierte und unsortierte Listen in LaTeX siehe Abschnitt 3.18. Listen im KOMA-Script Scrguide. Für typst siehe enum und list.

Für Links steht in LaTeX das mächtige Paket hyperref bereit. In typst gibt es das link-Element.

Fazit

Mir erscheint die typst-Syntax etwas einfacher, dafür weniger flexibel zu sein. Was mir besser gefällt, mag ich noch nicht sagen, da ich noch unentschlossen bin.

Das mit LaTeX erstellte PDF sieht in meinen Augen perfekt aus. Das mit typst erstellte PDF sieht ebenfalls gut aus und ist leserlich. Es reicht in meinen Augen jedoch nicht an die LaTeX-Ausgabe heran.

In typst ist meine Preambel kürzer, die Syntax etwas einfacher. Dafür war es mir nicht so einfach möglich, die Schriftart zu ändern. Diese hätte ich erst in meine typst-Binärdatei mit einkompilieren müssen. Ein Vorgang, der mir entschieden zu aufwendig ist.

Probiert es am besten aus und entscheidet selbst, welches Ergebnis euch besser gefällt. Ich vermag (noch) nicht zu sagen, ob mir LaTeX oder typst insgesamt besser gefallen. Werft ggf. zuerst einen Blick in den Guide for LaTeX Users.