Autorenarchiv: Jörg Kastning

Über Pinning (HPKP), CAA und Certificate Transparency

In der Vergangenheit habe ich mich auf diesem Blog bereits in verschiedenen Artikeln mit dem Thema Certificate Pinning befasst [vgl. 1-3]. Im vorliegenden Artikel möchte ich noch einmal kurz in Erinnerung rufen, worum es beim Pinning geht. Darüber hinaus finden Sie hier eine kurze Einführung in DNS Certification Authority Authorization (CAA) Resource Records (RFC 6844) [4] und Certificate Transparency (RFC 6962) [5].

Anschließend werden die vorgestellten Verfahren gegenübergestellt und hinsichtlich ihres Nutzens für einen „Subscriber“ und eine „Relying Party“ beurteilt.

Terminologie

Für das Verständnis des Artikels wichtige Begriffe werden in diesem Abschnitt definiert.

Subscriber stellt eine Entität dar, welche einen gesicherten Service anbieten möchte und hierfür ein Zertifikat benötigt.

Die Relying Party bezeichnet z.B. Webbrowser oder andere Programme, welche Zertifikate nutzen und versuchen, deren Echtheit zu validieren. Dies geschieht mit Hilfe von sogenannten trust anchors, also Zertifikaten, denen ultimativ vertraut wird und die in den Webbrowsern gespeichert sind.

Certificate Pinning (HPKP)

Update Februar 2020: HPKP existiert praktisch nicht mehr! Wie im Blog von Scott Helme vom 20.01.2020 nachzulesen ist, wurde die Unterstützung für HPKP [7] aus Firefox 72 entfernt. Damit wird HPKP von keinem aktuellen Browser mehr unterstützt und ist praktisch tot.

Ich lasse diesen Abschnitt zum Gedenken an diesen Mechanismus stehen. Die ebenfalls in diesem Artikel beschriebenen Verfahren CAA und Certificate Transparency gewinnen hingegen durch den Wegfall von HPKP weiter an Bedeutung.

Certificate Pinning wurde im RFC 7469 [7] spezifiziert. Es handelt sich dabei um einen Mechanismus, bestimmte Eigenschaften eines Zertifikats festzunageln. Der Browser erhält dabei mit dem Zertifikat zusätzliche Informationen, mit denen er die Authentizität des Zertifikats überprüfen kann.

In der Praxis wird dem Browser ein Hash-Wert übermittelt, welcher über den öffentlichen Schlüssel des Zertifikats gebildet wurde. Dieser Hash-Wert wird in einem HTTP-Header-Feld an den Browser übertragen und von diesem gespeichert. Wie dieses Verfahren genau funktioniert, beschreibt der RFC 7469 ab Abschnitt 2.1.1. Da nur der Dienstbetreiber über den dazugehörigen privaten Schlüssel verfügt, ist ein Missbrauch durch Dritte ausgeschlossen. Übermittelt nun nämlich ein Angreifer bei einem MITM-Angriff den zu seinem Zertifikat gehörenden öffentlichen Schlüssel, kann der Browser mit Hilfe des PINs erkennen, dass dieser Schlüssel nicht dem Dienstbetreiber gehört und den Angriff damit auffliegen lassen.

Dem Subscriber steht mit dem Certificate Pinning ein wirksamer Mechanismus zur Verfügung, mit dem sich das Risiko, Opfer eines MITM-Angriffs zu werden, deutlich reduzieren lässt. Gleichzeitig ist die Implementierung von Pinning in eigene Projekte nicht trivial und das Risiko, den eigenen Internetauftritt durch Fehlkonfiguration für Besucher unerreichbar zu machen, entsprechend hoch (vgl. [1], [2], [6] und [7]).

Certification Authority Authorization (CAA)

CAA wurde Anfang 2013 im RFC 6844 spezifiziert. Es handelt sich dabei um einen DNS Ressource Record, mit dem ein Domain-Inhaber festlegen kann, welche Zertifizierungsstellen (CA) für seine Domain Zertifikate ausstellen dürfen [4].

Eine gute Einführung in deutscher Sprache findet sich im DFN-PKI Blog in den Artikeln unter [8] und [9].

Die Zertifizierungsstellen wurden vom CA/Browser-Forum im Ballot 187 [10] verpflichtet, spätestens ab September 2017 die CAA Resource Records auszuwerten und zu beachten.

Certificate Transparency (CT)

Laut Abstract des RFC 6962 [5] handelt es sich bei Certificate Transparency um ein experimentelles Protokoll zur Buchführung über ausgestellte TLS-Zertifikate.

Die Idee besteht im Wesentlichen darin, dass Zertifizierungsstellen (CA) ausgestellte Zertifikate in ein öffentliches (mutmaßlich revisionssicheres) Log eintragen. Das Ziel ist, Transparenz bei der Ausstellung von TLS-Zertifikaten herzustellen. So soll jeder Klient einsehen können, für welche Domains Zertifikate ausgestellt wurden und welche Zertifizierungsstellen diese ausgestellt haben.

Durch Überwachung dieser Certificate Transparency Logs können Domain-Inhaber (Subscriber) feststellen, ob TLS-Zertifikate für ihre Domains ausgestellt wurden, ohne dass die Ausstellung von ihnen autorisiert wurde. In diesem Fall können sie Schritte einleiten, um diese Zertifikate widerrufen zu lassen. Für den Widerruf muss auf bestehende Verfahren zurückgegriffen werden, da der Zertifikatswiderruf explizit kein Bestandteil des aktuellen Entwurfs ist.

Wie stehen diese Verfahren zueinander?

Im Kern haben alle drei Verfahren zum Ziel, die größte Schwachstelle der Internet-PKI abzudichten. Nämlich das Problem, dass jede CA Zertifikate für jede beliebige Domain ausstellen darf und eine Relying Party bisher nur schwer erkennen konnte, ob ein vertrauenswürdiges Zertifikat tatsächlich mit Autorisierung des Domain-Inhabers ausgestellt wurde. Dabei verfolgen die drei Verfahren unterschiedliche Ansätze.

Das Certificate Pinning kann vom Subscriber selbst implementiert werden. Er stellt der Relying Party damit Informationen zur Verfügung, mit denen diese überprüfen kann, ob das gültige Zertifikat tatsächlich vom Subscriber bzw. einer von ihm autorisierten CA stammt. Liefert die Validierung eines PINs ein negatives Ergebnis, wird ein Zugriff auf die entsprechende Webseite durch den Webbrowser verweigert. Pinning stellt für den Subscriber ein wirksames Mittel dar, um das Risiko von Zertifikatsmissbrauch zu reduzieren.

Doch wo Licht ist, ist auch Schatten. Die Implementierung von Certificate Pinning ist komplex [1] und führt bei kleinsten Fehlern bereits zur Nichterreichbarkeit der eigenen Domain. Die Komplexität und das Risiko, die eigene Domain unerreichbar zu machen, sind Gründe, warum das Pinning bisher nur eine sehr geringe Verbreitung erfahren hat. Und damit nicht genug. Kaum in der Welt, wird bereits über den Abschied vom HTTP Public Key Pinning diskutiert (vgl. [12] und [13]) und von einem großen Browserhersteller sogar das Ende der Unterstützung eingeläutet (siehe [14] und [15]).

CAA bietet dem Subscriber bzw. Domain-Inhaber über DNS-Einträge die Möglichkeit, CAs zur Ausstellung von Zertifikaten zu autorisieren. Dieser Schutz wirkt passiv, da er darauf basiert, dass sich die CAs an die Verpflichtung aus [10] halten. Schert sich eine CA nicht um diese Verpflichtung, wird durch staatliche Stellen zur Ausstellung von Zertifikaten gezwungen oder durch Einbruch kompromittiert [6, Abschnitt 2.5], können weiterhin Zertifikate ausgestellt werden, denen die Relying Party vertraut. Da eine Nutzung von CAA durch die Relying Party zum Zweck der Zertifikatsvalidierung explizit ausgeschlossen ist [8]. Auch der Subscriber muss sich auf die Selbstverpflichtung der CAs verlassen; kann er doch nicht prüfen, ob eine CA ein Zertifikat ohne seine Autorisierung ausgestellt hat.

Wer sich nun fragt, warum sich eine CA an CAA gebunden fühlen sollte, dem sei gesagt, dass bei einem Verstoß gegen CAA die Entfernung der eigenen Root CA aus dem trust anchor der Relying Party droht. So sollte es im eigenen Interesse einer CA liegen, CAA Records gewissenhaft auszuwerten und sich möglichst keine Fehler zu erlauben.

Certificate Transparency bietet einem Subscriber die Möglichkeit, durch Überwachung der CT Logs zu erkennen, ob TLS-Zertifikate ohne Autorisierung des Subscribers ausgestellt wurden. Dies setzt natürlich voraus, dass die ausstellende CA diese Zertifikate auch in einem CT Log einträgt. Doch welche Motivation hat eine CA, dies zu tun? Wenn die Browser (Relying Party) mit der größten Verbreitung zukünftig nur noch Zertifikate als vertrauenswürdig einstufen, welche in einem CT Log aufzufinden sind, wäre dies sicherlich eine Motivation. So könnten die großen Browserhersteller dieser Welt mit ihrer Marktmacht doch eine Transparenz erzwingen.

Mein persönliches Fazit

Als das Public Key Pinning das Licht der Welt erblickte, war ich von dessen Möglichkeiten begeistert und habe es auch selbst in verschiedenen Umgebungen eingesetzt (siehe [1] und [6]). Dabei habe ich erkannt, dass der Einsatz mit hohen Risiken verbunden ist und man sich sehr viele Gedanken über mögliche Auswirkungen in der Zukunft machen muss. Aktuell setze ich in meinen Projekten auf Grund der Risiken kein Pinning mehr ein. Googles Ankündigung, die Unterstützung aus dem Chrome Browser zu entfernen, klingt wie ein Todesstoß für dieses Verfahren. Es bleibt abzuwarten, ob Mozilla mit dem Firefox nachzieht oder das Pinning als Abgrenzungsmerkmal weiter unterstützt.

Insgesamt würde ich mich freuen, wenn man HPKP doch noch retten kann. Denn im Gegensatz zu CAA und CT stellt es für mich die effizienteste und wirksamste Technik dar, um mich selbst und meine Nutzer vor Zertifikatsbetrug schützen zu können. Dies sage ich, ohne CAA und CT damit abwerten zu wollen. Auch diese beiden Verfahren tragen dazu bei, die Schwachstelle im Design der Internet-PKI zu verkleinern und sie können gerade in Kombination dazu beitragen, das Potenzial für Zertifikatsmissbrauch deutlich zu reduzieren.

Quellen und weiterführende Links

  1. Certificate Pinning mit NGINX
  2. Pinning-Test im Firefox bei lokaler Root-CA erzwingen
  3. Mein TLS/SSL-Kochbuch
  4. DNS Certification Authority Authorization (CAA) Resource Record – RFC 6844 {en}
  5. Certificate Transparency – RFC 6962 {en}
  6. TLS-Kochbuch – Rezepte für die Verwendung von OpenSSL, HTTP Strict Transport Security (HSTS) und HTTP Public Key Pinning (HPKP)
  7. Public Key Pinning Extension for HTTP – RFC 7469 {en}
  8. RFC 6844 Certification Authority Authound Folgenrization (CAA)
  9. CAA RRs – Reihenfolge im DNS
  10. Ballot 187 – Make CAA Checking Mandatory {en}
  11. http://www.certificate-transparency.org/ {en}
  12. Ivan Ristic Is HTTP Public Key Pinning Dead? {en}
  13. Scott Helme: I’m giving up on HPKP {en}
  14. Scott Helme: The death knell for HPKP? {en}
  15. heise Security: HTTPS-Verschlüsselung: Google verabschiedet sich vom Pinning
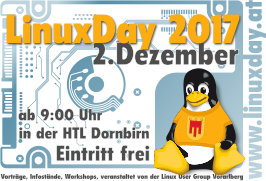
Vorträge 2017 auf der OpenRheinRuhr und dem LinuxDay in Vorarlberg

Nicht ganz uneigennützig möchte ich mit diesem Beitrag auf zwei Veranstaltungen zu den Themen Open Source, Freie Software und Linux in diesem Jahr hinweisen. Beide Veranstaltungen haben gemeinsam, dass ich auf ihnen mit verschiedenen Vorträgen vor Ort bin.

OpenRheinRuhr 2017

Bereits kommende Woche findet vom 4.-5. November die OpenRheinRuhr im Rheinischen Industriemuseum in Oberhausen statt.

Ich selbst bin dieses Jahr zum ersten Mal auf der OpenRheinRuhr zu Gast und freue mich bereits auf spannende Themen und darauf, das ein oder andere vertraute Gesicht wiederzusehen. Von mir gibt es als Beitrag zur diesjährigen Veranstaltung am 4. November um 17 Uhr eine Einführung und kritische Betrachtung von Ansible.

LinuxDay in Vorarlberg

Am 2. Dezember diesen Jahres bin ich dann beim LinuxDay in Vorarlberg (Österreich) zu Gast. Die Veranstaltung legt den inhaltlichen Schwerpunkt dieses Jahr auf die Themen Privatsphäre und Sicherheit. Dazu gibt es um 15 Uhr mit meinem Vortrag „Webseiten mit HTTPS bereitstellen und mit HSTS und HPKP sichern“ einen Einblick in die Welt der Internet-PKI, ihrer Schwachstellen und zwei ausgewählte Methoden, um die Angriffsfläche zu verkleinern.

Der Vortrag ist ein Auszug aus meinem TLS-Kochbuch, welches unter dem angegebenen Link kostenlos zum Download zur Verfügung steht.

Ich freue mich bereits darauf, unsere Nachbarn im Süden zu besuchen, sowie altbekannte und neue Mitglieder der Gemeinschaft kennenzulernen.
LinuxDay 2017 am 2. Dez in Dornbirn

Linux: Wann ist ein Neustart erforderlich?

Es ist allgemein bekannt, dass ein Neustart erforderlich ist, um einen neu installierten oder aktualisierten Kernel zu laden. Doch gibt es auch noch weitere Pakete, welche den Neustart eines Hosts erforderlich machen. Dieser Artikel beschreibt Methoden für CentOS, RHEL, Oracle Linux, Debian und Ubuntu, mit denen geprüft werden kann, ob ein Neustart erforderlich ist oder nicht.

Prüfung unter CentOS, RHEL, Oracle Linux

Unter den genannten Distributionen existiert das Programm needs-restarting, welches durch das Paket yum-utils bereitgestellt wird. Dieses kann genutzt werden, um Prozesse anzuzeigen, die aktualisiert wurden:

# needs-restarting
477 : /usr/bin/VGAuthService -s

Die Ausgabe gibt die Prozess-ID und den Namen des Prozesses zurück. Möchte man prüfen, ob ein Neustart des gesamten Systems erforderlich ist, so nutzt man die Option -r:

# needs-restarting -r
Core libraries or services have been updated:
  kernel -> 3.10.0-693.1.1.el7

Reboot is required to ensure that your system benefits from these updates.

More information:
https://access.redhat.com/solutions/27943

Obige Ausgabe deutet darauf hin, dass ein Neustart erforderlich ist, da ein neuer Kernel installiert wurde. Auf einem neugestarteten System sieht die Ausgabe wie folgt aus:

$ sudo needs-restarting -r
No core libraries or services have been updated.
Reboot is probably not necessary

Prüfung unter Debian und Ubuntu

Um festzustellen, ob ein Neustart erforderlich ist oder nicht, kann man prüfen, ob die Datei /var/run/reboot-required existiert. Existiert die Datei, ist es angeraten, einen Neustart des Systems durchzuführen. Ist die Datei hingegen nicht vorhanden, ist höchstwahrscheinlich auch kein Neustart erforderlich.

Quellen und weiterführende Links

Geschwindigkeit von PowerLAN mit iperf messen

PowerLAN, auch bekannt als dLAN oder Powerline, bezeichnet eine Technologie, zum Aufbau eines lokalen Netzwerks, unter Nutzung vorhandener Stromleitungen.

Adapter verschiedener Hersteller versprechen dabei eine Übertragungsgeschwindigkeit von bis zu 2000 Mbit/s. Doch ob diese Geschwindigkeit im eigenen Haushalt auch nur annähernd erreicht wird hängt von vielen Faktoren ab. Darunter fallen z.B. Alter und Zustand der Hausverkabelung, aber auch angeschlossene elektrische Geräte können die Übertragungsgeschwindigkeit negativ beeinflussen.

Um die Geschwindigkeit des PowerLAN zu messen bietet sich das Programm iperf an, welches unter allen gängigen Linux-Distributionen zur Verfügung steht.

Test der Messmittel

Bevor man mit der Messung beginnt und viel Mist misst, sollte man noch ein paar Dinge beachten.

Um mit iperf die Geschwindigkeit des Netzwerks zu messen, kommen in meinem kleinen Versuchsaufbau zwei Notebooks mit Ubuntu 16.04 LTS und Gigabit-Netzwerkkarte zum Einsatz. Denn selbstverständlich haben auch die Geschwindigkeit der verwendeten Netzwerkkarten und selbst der Netzwerkkabel einen Einfluss auf das Messergebnis. Verwendet man Netzwerkkarten mit einer Geschwindigkeit von 100 Mbit/s oder ist schon ein paar Mal mit dem Bürostuhl über das Netzwerkkabel gerollt, darf man sich nicht wundern, wenn man nicht mal annähernd an die versprochene Geschwindigkeit herankommt. Aber auch andere Programme, die evtl. zur gleichen Zeit ausgeführt werden und das Netzwerk nutzen, können die Messergebnisse beeinträchtigen. Es gilt diese Störfaktoren möglichst auszuschließen.

Die beiden Notebooks verbinde ich zuerst über einen Gbit-Switch miteinander. Dazu verwende ich die neuen LAN-Kabel, welche den PowerLAN-Adaptern beiliegen. Dank IPv6 ist keine weitere Konfiguration der Schnittstellen erforderlich. Es können direkt die link-local Adressen genutzt werden, um miteinander zu kommunizieren. Nun wird auf einem der beiden Notebooks iperf (iperf -s) im Servermodus gestartet, womit es auf eingehende Verbindungen wartet.

Auf dem anderen Notebook wird iperf im Client-Modus gestartet (iperf -c hostname), welches sich dann zum Server verbindet und mit der Messeung beginnt. Das Ergebnis einer solchen Messung ist der folgenden Ausgabe zu entnehmen:

------------------------------------------------------------
Client connecting to fe80::%eth0, TCP port 5001
TCP window size: 85.0 KByte (default)
------------------------------------------------------------
[  3] local fe80:: port 47748 connected with fe80:: port 5001
[ ID] Interval       Transfer     Bandwidth
[  3]  0.0-10.0 sec  1.07 GBytes   915 Mbits/sec

Bei ca. 10 Wiederholungen dieses Tests lag die Geschwindigkeit stets zwischen 910 Mbits/s und 936 Mbits/s. Für einen kleinen SoHo-Switch ein hervorragendes Ergebnis. Nun bin ich natürlich gespannt, ob die PowerLAN-Adapter die angepriesene Geschwindigkeit ebenfalls liefern können.

Messung der PowerLAN-Verbindung

Die PowerLAN-Adapter wurden direkt in Wandsteckdosen eingesetzt. Die integrierten Steckdosen sollen von weiteren Endgeräten verursachte Störungen auf der Leitung herausfiltern und so die bestmögliche Leistung garantieren.

In meinem Versuchsaufbau befand sich ein Adapter im Erdgeschoss, während der andere im darüberliegenden Raum im 1. OG angeschlossen wurde. Beide Adapter haben sich innerhalb kurzer Zeit gefunden und zu einem Paar verbinden lassen.

Anschließend wurde die Übertragungsgeschwindigkeit mit iperf gemessen. Die Messung wurde mehrfach wiederholt, um Ausreißer erkennen zu können. Das Ergebnis war leider sehr enttäuschend. Die durchschnittliche Übertragungsrate lag bei 31 Mbit/s. Ausreißer gab es ledigich nach unten, wo bei einigen Tests nur 7 Mbit/s übertragen wurden.

In der Folge habe ich noch weitere Messungen an anderen Steckdosen im Haus durchgeführt, kam aber nicht über eine maximale Übertragungsrate von 36 Mbit/s hinaus. Hinzu kommt die Beobachtung, dass die getesteten Adapter während einer Messung wiederholt die Verbindung zueinander verloren und Messungen wiederholt werden mussten.

Leider bestätigten sich damit Ergebnisse aus früheren Tests, so dass kein sinnvoller Einsatz dieser Technik in unserem Haus möglich scheint.

Fazit

PowerLAN verspricht die schnelle und einfache Vernetzung von netzwerkfähigen Geräten über das Stromnetz in der eigenen Wohnung bzw. im eigenen Haus. Die versprochenen Übertragungsraten von teilweise mehr als 1 Gbit/s werden dabei jedoch nicht in jedem Fall erreicht. Häufig liegen diese sogar deutlich unter den angegebenen Maximalwerten. Daher ist ein Test der Übertragungsgeschwindigkeit in jedem Fall empfehlenswert.

Bevor man jedoch mit der Messung beginnt, sollte man die eingesetzten Messmittel auf ihre Tauglichkeit und Leistungsfähigkeit hin überprüfen. Denn sonst gilt wieder: „Wer viel misst, misst viel Mist.“

Was sind die maximalen und minimalen Werte für UID und GID in den verschiedenen Linux-Distributionen?

In verschiedenen Kreisen kam wiederholt die Frage auf, aus welchem Bereich unter Linux die Werte für UID und GID stammen. Diese Frage möchte ich in diesem Beitrag beantworten.

Der maximal mögliche Wert, den eine UID oder GID annehmen kann, wird vom Typ der Variablen bestimmt, in der dieser Wert gespeichert wird. Bei den im Folgenden betrachteten Distributionen besitzen diese Integer-Variablen eine Größe von 32 Bit. Der maximal mögliche Wert für UID bzw. GID liegt in diesen Distributionen also bei 4.294.967.295. Wie die Größe dieser Variablen ermittelt werden kann, wird in der Red Hat Wissensdatenbank beschrieben.

Darüber hinaus definieren die Distributionen in der Datei /etc/login.defs einen Bereich, aus dem eine automatische Vergabe bei der Verwendung der Kommandos useradd bzw. groupadd erfolgt.

Min- und Maximal-Werte für UID und GID

Min/Max-WerteUbuntu 16.04 LTSRHEL/CentOS 7SLES 12 SP1
UID_MIN100010001000
UID_MAX600006000060000
SYS_UID_MIN100201100
SYS_UID_MAX999999499
GID_MIN100010001000
GID_MAX600006000060000
SYS_GID_MIN100201100
SYS_GID_MAX999999499
Voreingestellte Minima und Maxima für UID und GID verschiedener Distributionen

UID und GID gelten für „normale“ Benutzer, während SYS_UID und SYS_GID die Grenzen für Systembenutzer angeben.

Quellen und weiterführende Links

Wer keine Online-Anfragen wünscht, sollte das Kontaktformular schließen

Seien Sie gegrüßt. Bieten Sie auf ihrer Webseite im Bereich Kontakt auch ein Kontaktformular an? Zur allgemeinen Kontaktaufnahme oder evtl. auch zur Online-Terminvereinbarung? Versprechen Sie ihren Besuchern evtl. sogar, auf eingehende Anfragen zu reagieren?

Wenn einer dieser Punkte auf Sie zutrifft und Sie ihren Besuchern tatsächlich auf eingehende Nachrichten bzw. Terminanfragen antworten, dann haben Sie vielen Dank dafür. Sie müssen von hier ab nicht weiterlesen.

Sie wissen gar nicht, ob Sie so ein Kontaktformular auf Ihrer Webseite haben? Dann schauen Sie vielleicht mal nach, ob es dort nicht doch eines gibt. Und wenn Sie sowieso nicht vorhaben, auf Nachrichten, die Sie auf diesem Weg erreichen, zu antworten, habe ich eine Bitte. Schalten Sie das Kontaktformular ab. Bieten Sie diesen Kommunikationsweg nicht mehr an. Sie ersparen sich selbst unerwünschte Nachrichten und allen anderen Besuchern Zeit und Frust.

Warum das so ist, möchte ich Ihnen gerne erklären. Wie viele andere heute lebende Menschen gehöre ich zur Generation Y. Das bedeutet unter anderem, dass ich sehr gerne online kommuniziere, einkaufe, Medien konsumiere usw. Manche behaupten sogar, dass ich per E-Mail schneller reagiere, als bei entgangenen Anrufen zurückzurufen. Für mich hat dies einige ganz entscheidende Vorteile. Ich kann Sie kontaktieren, wann es mir passt. Dann wann ich Zeit habe.

So könnte ich z.B. einen Zahnarzttermin vereinbaren, ohne minutenlang in der Warteschleife der Praxis zu hängen. Ich könnte einfach und zeitsparend bei mehreren Fachärzten anfragen, ob sie überhaupt noch Patienten nehmen und wann ich einen Termin bekommen kann. Gleiches gilt für Handwerker, denen ich den zu vergebenen Auftrag schildern und ein Angebot anfordern könnte. Oder den Kabelnetzbetreiber, den ich um Auskunft zu bestehenden Vertragsoptionen bitten könnte.

Leider bleibt es allzu oft beim Konjunktiv. Denn oftmals sind diese Kontaktmöglichkeiten nichts weiter als schwarze Löcher. Selbst auf wiederholte Anfragen erhalte ich keine Antwort.

Also bleibt wie so oft doch wieder nur der Griff zum Telefon. Fragt man bei der Gelegenheit nach, warum man auf elektronische Anfragen keine Antwort erhält, reichen die Aussagen von „Ihre Nachricht ist nicht angekommen, dass kommt schon mal vor“ bis hin zu „Wir haben so viel zu tun, da können wir nicht auch noch auf jede Nachricht antworten.“

Und ob Sie es glauben oder nicht, ich habe Verständnis dafür. Nicht jeder gehört zur Generation Y und kann einen Computer bedienen und das Internet nutzen. Ich bin mir bewusst, dass es viele Menschen schaudert, wenn sie an den täglichen Kampf mit ihrem E-Mail-Programm denken. Und ich habe vollstes Verständnis dafür, dass jeder irgendwann Feierabend hat und dann nicht noch 1337 E-Mails beantworten möchte. In diesen Fällen wiederhole ich meine Bitte von oben:

Dann lassen Sie doch endlich die Kontaktformulare von Ihrer Webseite entfernen!

Ganz ehrlich, Sie brauchen sie nicht. Ihre Webseite wird auch ohne Kontaktformular funktionieren. Besucher erkennen sofort, dass Sie auf diesem Wege nicht erreichbar sind und verschwenden nicht ihre Zeit mit der Formulierung einer ausführlichen Anfrage.

Und wenn Sie schon dabei sind, prüfen Sie doch gleich, ob die veröffentlichten Öffnungszeiten noch korrekt sind. Dann stehe ich zukünftig nicht mehr vor verschlossenen Türen (an denen übrigens auch die falschen Öffnungszeiten stehen).

Wer viel misst, misst viel Mist

Im Falle dieses Artikels bezieht sich der Titel auf das Messen von Temperatur und relativer Luftfeuchtigkeit mit einem DHT22-Sensor (AM2302).

Im Rahmen eines kleinen Wochenend-Projekts möchte ich mit Hilfe des genannten Sensors, der Open-Source-Plattform NodeMCU V3 und einem Raspberry Pi eine Raumklimaüberwachung für unsere Wohnung basteln. Der NodeMCU V3 mit aufgesetztem ESP8266 scheint dazu gut geeignet, da er dank integriertem WLAN die aufgezeichneten Messdaten direkt an eine zentrale Instanz übertragen kann. An dieser Stelle beschreibe ich, wie ich dabei vorgegangen bin, welche Komponenten zum Einsatz kamen, wie der Prototyp funktioniert, welche Erkenntnisse ich dabei gewonnen habe und was ich damit in Zukunft anzustellen gedenke.

Vorwort zum Prototyp

Für meine Bastelei verwende ich am liebsten den DHT22-Sensor. Dieser ist günstig und liefert eine hinreichende Genauigkeit. Mir ist jedoch in der Vergangenheit aufgefallen, dass einzelne Exemplare in ihren Messwerten teils deutlich nach oben oder unten ausreißen.

Um nun herauszufinden, ob sich in der jüngsten Charge wieder ein paar Ausreißer befinden, habe ich mich für einen demokratischen Ansatz entschieden. Dabei schließe ich mehrere Sensoren an den gleichen Mikrocontroller an und messe mit ihnen am gleichen Ort. Theoretisch dürfen die Messwerte nur in dem angegebenen Toleranzbereich von maximal +/- 5% RH und +/- 0,5 °C abweichen. Mit der parallelen Anordnung von vier Sensoren kann ich erkennen, ob einer aus der Reihe tanzt.

Vorbereitung der Plattform

Als Firmware für den ESP8266 habe ich ESPEasy ausgewählt. Das Projekt verfügt über ein gut strukturiertes Wiki, welches in englischer Sprache erklärt, wie man die Firmware auf den ESP8266 installiert.

Aufbau des Prototyps

Für den Aufbau habe ich zwei kĺeine Steckbretter und ein NodeMCU V3 verwendet. Der Aufbau wird im folgenden Bild dargestellt. Da dies mein erster Versuch war, einen Aufbau zu modellieren, bitte ich um etwas Nachsicht.

dht22-on-esp8266

Aufbau des Prototypen

Es wurden Pull-Up-Widerstände mit einem Widerstand von 10k Ohm verwendet und an die GPIO-PINs 12, 13, 14 und 16 angeschlossen.

Eine Übersicht über alle zur Verfügung stehenden PINs bietet das folgende Bild:

PIN-Belegung des NodeMCU

Wurde die Schaltung wie im obigen Bild aufgebaut, verbindet man sich mit der Weboberfläche des ESPEasy und konfiguriert diesen entsprechend. Eine ausführliche Dokumentation zum Webinterface findet man unter der URL https://www.letscontrolit.com/wiki/index.php/ESP_Easy_web_interface.

In meinem Aufbau erscheinen die Sensoren nach erfolgreicher Konfiguration wie folgt unter „Devices“ im Webinterface.

Devices im Webinterface des ESPEasy

Die meisten Schritte sind intuitiv zu bearbeiten. Lediglich zur Konfiguration des Template-Strings, welcher zur Übertragung der Messwerte an einen Webserver verwendet wird, habe ich etwas länger gebraucht. Ich verwende dazu folgenden Publish-Template-String, welcher unter Tools -> Advanced -> Publish Template eingetragen wird.

import.php?name=%sysname%&task=%tskname%&valuename=%valname%&value=%value%

Das folgende Listing zeigt, wie die HTTP-GET-Anfragen beim Webserver ankommen:

192.168.x.x 192.168.x.x - [07/Jun/2017:20:44:05 +0200] "GET /import.php?name=esp8266%5fdht22%5f2&task=DHT22%2d1&valuename=Temperature&value=22.00 HTTP/1.1" 200 411 "-" "-"
192.168.x.x 192.168.x.x - [07/Jun/2017:20:44:06 +0200] "GET /import.php?name=esp8266%5fdht22%5f2&task=DHT22%2d1&valuename=Humidity&value=43.60 HTTP/1.1" 200 411 "-" "-"
192.168.x.x 192.168.x.x - [07/Jun/2017:20:44:07 +0200] "GET /import.php?name=esp8266%5fdht22%5f2&task=DHT22%2d2&valuename=Temperature&value=22.00 HTTP/1.1" 200 411 "-" "-"
192.168.x.x 192.168.x.x - [07/Jun/2017:20:44:08 +0200] "GET /import.php?name=esp8266%5fdht22%5f2&task=DHT22%2d2&valuename=Humidity&value=44.30 HTTP/1.1" 200 411 "-" "-"
192.168.x.x 192.168.x.x - [07/Jun/2017:20:44:09 +0200] "GET /import.php?name=esp8266%5fdht22%5f2&task=DHT22%2d3&valuename=Temperature&value=22.10 HTTP/1.1" 200 411 "-" "-"
192.168.x.x 192.168.x.x - [07/Jun/2017:20:44:10 +0200] "GET /import.php?name=esp8266%5fdht22%5f2&task=DHT22%2d3&valuename=Humidity&value=55.20 HTTP/1.1" 200 411 "-" "-"
192.168.x.x 192.168.x.x - [07/Jun/2017:20:44:11 +0200] "GET /import.php?name=esp8266%5fdht22%5f2&task=DHT22%2d4&valuename=Temperature&value=22.00 HTTP/1.1" 200 411 "-" "-"
192.168.x.x 192.168.x.x - [07/Jun/2017:20:44:12 +0200] "GET /import.php?name=esp8266%5fdht22%5f2&task=DHT22%2d4&valuename=Humidity&value=44.30 HTTP/1.1" 200 411 "-" "-"

Der Aufbau des Prototyps ist damit im Wesentlichen abgeschlossen.

Erstellung der import.php

In meinem Heimnetzwerk befindet sich bereits ein Raspberry Pi, auf welchem ein kleiner Webserver (lighttpd) läuft. Für diesen erstelle ich ein kleines Import-Skript, welches die Messdaten einsammelt und in eine Datei schreibt.

Für die Erstellung der Datei „import.php“ nehme ich an, dass die Ergebnisse der vier Sensoren stets in der gleichen Reihenfolge übermittelt werden. Da jeweils Temperatur und Luftfeuchtigkeit gemessen werden, überträgt der ESP8266 acht Werte pro Messintervall. Diese sollten mit einem Zeitstempel in eine Zeile einer CSV-Datei geschrieben werden. Dafür kommt aktuell das folgende Skript zum Einsatz:

switch ($_GET[„task“]) {
case „DHT22-1“:
if ($_GET[„valuename“] == ‚Temperature‘) {
$data = date(‚Y-m-d‘). „T“ . date(‚H:i:s‘, time()) . „,“ . $_GET[„value“] . „,“;
} else {
$data = $_GET[„value“] . „,“;
}
break;
case „DHT22-2“:
if ($_GET[„valuename“] == ‚Temperature‘) {
$data = $_GET[„value“] . „,“;
} else {
$data = $_GET[„value“] . „,“;
}
break;
case „DHT22-3“:
if ($_GET[„valuename“] == ‚Temperature‘) {
$data = $_GET[„value“] . „,“;
} else {
$data = $_GET[„value“] . „,“;
}
break;
case „DHT22-4“:
if ($_GET[„valuename“] == ‚Temperature‘) {
$data = $_GET[„value“] . „,“;
} else {
$data = $_GET[„value“] . „\n“;
}
break;
}

print($data);
file_put_contents(‚/var/www/dht22data.csv‘, $data, FILE_APPEND);


Erste Erkenntnisse

Im aktuellen Aufbau werden die Messwerte alle 5 Minuten an den Webserver übertragen. Die empfangenen Daten habe ich mit LibreOffice Calc geöffnet und etwas aufbereitet:

Erste Messergebnisse (aufbereitet)

Die Messwerte wurden auf ganze Zahlen gerundet. Es lässt sich erkennen, dass tatsächlich ein Sensor aus der Reihe tanzt. Der DHT22-3 weicht bei der Luftfeuchtigkeit um 9-11 Prozentpunkte nach oben ab. Das ist erstmal nicht weiter schlimm, jedoch gut zu wissen. Ich werde die nächste Zeit beobachten, wie sich diese Abweichung bei wechselnden Temperaturen entwickelt.

Entweder passe ich die gemessenen Werte an, indem ich in der Weboberfläche einen festen Faktor zu den gemessenen Werten hinzurechne bzw. abziehe oder ich sondere den Sensor aus, sollte die Abweichung zu stark schwanken.

Ausblick

Die nächsten Tage werde ich den Prototyp in seiner aktuellen Konfiguration weiterlaufen lassen. Anschließend beschaffe ich mir ein paar kleine Gehäuse, um jeweils einen Sensor mit einem Controller zusammen einzusetzen und in der Wohnung aufzustellen. So weiß ich in Zukunft schon vorher, ob es sich lohnt, die Wohnung zu betreten oder ich lieber gleich in den Garten gehe.

Darüber hinaus habe ich noch eine Handvoll weiterer DHT22-Sensoren. Diese werde ich ebenfalls auf einem Steckbrett anordnen und sie an einen Raspberry Pi anschließen. Ich werde bei diesen das gleiche Verfahren anwenden, um Ausreißer erkennen zu können.

RHEL 7: Wie stelle ich sicher, dass nur Pakete aus unterstützten Quellen installiert sind?

In diesem Artikel dokumentiere ich (vor allem für mich selbst), wie man ein System in einen Zustand versetzen kann, in dem ausschließlich RPM-Pakete aus Repositories (Repos) installiert sind, für die man kommerziellen Support erhält.

Dazu gehe ich kurz auf den Hintergrund der Aufgabenstellung ein, bevor ich anschließend eine mögliche Lösung beschreibe.

Die Hintergrundgeschichte

Für meine ersten Gehversuche mit Red Hat Enterprise Linux habe ich mich unter der URL „https://developers.redhat.com/“ für eine Developer Subscription registriert. Diese gestattet die unbeschränkte Nutzung zu Forschungs- und Entwicklungszwecken.

Mit der Developer Subscription erhält man Zugriff auf eine ganze Reihe von Repos, aus denen man Software installieren kann. Etliche Pakete wie z.B. sed, less, etc. sind dabei in mehreren Quellen verfügbar.

Nach einer gewissen Evaluierungszeit sollte das System produktiv genutzt werden. Da eine produktive Nutzung in der Developer Subscription ausgeschlossen ist, wurde eine RHEL Standard Subscription für das System beschafft. Diese wurde dem System über den „Subscription Manager“ hinzugefügt. Die Developer Subscription wurde im Gegenzug entfernt.

Um zu überprüfen, ob auf dem System Pakete aus anderen Repos als „rhel-7-server-rpms“ installiert waren, wurde folgendes Kommando genutzt:

# yum list installed | grep -v "rhel-7-server-rpms\|anaconda"
Loaded plugins: product-id, search-disabled-repos, subscription-manager
Installed Packages
NetworkManager-config-server.x86_64
Red_Hat_Enterprise_Linux-Release_Notes-7-en-US.noarch
libdnet.x86_64 1.12-13.1.el7 @rhel-7-server-eus-rpms
libicu.x86_64 50.1.2-15.el7 @rhel-7-server-eus-rpms
libmspack.x86_64 0.5-0.4.alpha.el7 @rhel-7-server-eus-rpms
net-tools.x86_64 2.0-0.17.20131004git.el7 @rhel-7-server-eus-rpms
sed.x86_64 4.2.2-5.el7.sjis.1 @rhel-sjis-for-rhel-7-server-eus-rpms

# yum repolist enabled
Loaded plugins: product-id, search-disabled-repos, subscription-manager
repo id repo name status
rhel-7-server-rpms/7Server/x86_64 Red Hat Enterprise Linux 7 Server (RPMs) 14,280
repolist: 14,280

Der Ausgabe ist zu entnehmen, dass fünf Pakete aus Quellen stammen, die auf dem System nicht mehr verfügbar sind. Diesen Zustand galt es zu ändern.

Die Lösung

Für die ersten vier Pakete bestand die Lösung darin, diese einfach neuzuinstallieren:

yum reinstall libdnet libicu libmspack net-tools

Bei sed stellte sich dieser Ansatz als problematisch heraus, da der Versuch das Paket neuzuinstallieren mit folgender Meldung quittiert wurde:

# yum reinstall sed
Loaded plugins: langpacks, product-id, search-disabled-repos, subscription-manager
rhel-7-server-optional-rpms | 3.5 kB 00:00:00
rhel-7-server-rpms | 3.5 kB 00:00:00
rhel-server-rhscl-7-rpms | 3.5 kB 00:00:00
Installed package sed-4.2.2-5.el7.sjis.1.x86_64 (from rhel-sjis-for-rhel-7-server-eus-rpms) not available.
Error: Nothing to do

Der zweite Ansatz, das Paket erst zu entfernen und dann erneut zu installieren, scheiterte an der Überprüfung der Paket-Abhängigkeiten (Auszug der Ausgabe):

# yum remove sed
[...]
--> Finished Dependency Resolution
Error: Trying to remove "systemd", which is protected
Error: Trying to remove "yum", which is protected

Die Lösung gelang mit dem dritten Versuch. Hierbei wurde ein Downgrade auf die Paket-Version aus dem Repo „rhel-7-server-rpms“ durchgeführt:

# yum downgrade sed-4.2.2-5.el7.x86_64
Loaded plugins: langpacks, product-id, search-disabled-repos, subscription-manager
Resolving Dependencies
--> Running transaction check
---> Package sed.x86_64 0:4.2.2-5.el7 will be a downgrade
---> Package sed.x86_64 0:4.2.2-5.el7.sjis.1 will be erased
--> Finished Dependency Resolution

Dependencies Resolved

===============================================================================================================================================================
Package Arch Version Repository Size
===============================================================================================================================================================
Downgrading:
sed x86_64 4.2.2-5.el7 rhel-7-server-rpms 231 k

Transaction Summary
===============================================================================================================================================================
Downgrade 1 Package

Total download size: 231 k
Is this ok [y/d/N]: y
Downloading packages:
sed-4.2.2-5.el7.x86_64.rpm | 231 kB 00:00:00
Running transaction check
Running transaction test
Transaction test succeeded
Running transaction
Installing : sed-4.2.2-5.el7.x86_64 1/2
Cleanup : sed-4.2.2-5.el7.sjis.1.x86_64 2/2
Verifying : sed-4.2.2-5.el7.x86_64 1/2
Verifying : sed-4.2.2-5.el7.sjis.1.x86_64 2/2

Removed:
sed.x86_64 0:4.2.2-5.el7.sjis.1

Installed:
sed.x86_64 0:4.2.2-5.el7

Complete!
# yum list installed | grep sed
sed.x86_64 4.2.2-5.el7 @rhel-7-server-rpms

Am Ende des Listings ist zu sehen, dass sed nun aus dem Repo „rhel-7-server-rpms“ installiert wurde. Damit stammen nun alle Pakete wieder aus Quellen, die von einer Subscription mit Support abgedeckt.

Bei zukünftigen Installationen mit einer Developer Subscription werde ich jedoch von Anfang an darauf achten, dass nur die Repos verwendet werden, die auch in der RHEL Standard Subscription enthalten sind.

Verweise

vSphere PowerCLI: Snapshots nach Namen suchen und löschen

In diesem Beitrag möchte ich kurz dokumentieren, wie vSphere Snapshots mit Hilfe der PowerCLI nach Namen gesucht und gelöscht werden können.

Anwendungsfall

Beruflich betreue ich mehrere vSphere-Cluster mit einigen hundert virtuellen Maschinen (VMs). Um diese VMs zu sichern, kommt eine Image-Backup-Software zum Einsatz. Diese erstellt zum Zeitpunkt der Sicherung von jeder VM einen Snapshot, sichert die zur VM gehörenden Dateien und löscht den Snapshot anschließend wieder.

Läuft es mal nicht so gut und das Backup wird unterbrochen oder schlägt fehl, werden diese Snapshots nicht immer von allen VMs entfernt. Diese liegengebliebenen Snapshots von Hand suchen und löschen zu müssen, macht keinen Spaß. Zum Glück lässt sich diese Aufgabe automatisieren.

Alle Snapshots mit einem bestimmten Namen löschen

Mit der folgenden Befehlszeile wird der verbundene vCenter Server angewiesen, alle Snapshots, die dem spezifizierten Namensmuster entsprechen, zu löschen:

Get-VM | Get-Snapshot | Where {$_.Name -like "SNAPSHOTNAME*"} | Remove-Snapshot -Confirm:$false

Es wird dabei immer ein Snapshots nach dem anderen gelöscht. Dies kann durch Angabe des Parameters RunAsync beschleunigt werden. Es ist jedoch zu beachten, dass durch die Parallelisierung eine hohe I/O-Last im Storage erzeugt wird. Damit besteht das Risiko, den gesamten Cluster lahmzulegen.

Möchte man statt des Namens des Snapshots dessen Beschreibung verwenden, ist dies mit folgendem Befehl ebenfalls möglich:

get-vm | get-snapshot | where {$_.Description -match "Snapshot generated for backup"}| Remove-Snapshot -Confirm:$false

Quellen und weiterführende Links

mysql_upgrade – prüft und aktualisiert MySQL-Tabellen

Vergangenes Wochenende hat KOFREZO unseren Server von Ubuntu Trusty Tahr auf die aktuelle LTS-Version Xenial Xerus aktualisiert. Einhergehend mit dem Release-Upgrade wurde MySQL auf Version 5.7 aktualisiert.

Beim ersten Versuch, ein Backup meiner Datenbank mit mysqldump zu erzeugen, wurde ich überraschend mit folgender Fehlermeldung konfrontiert:


mysqldump: Couldn't execute 'SHOW VARIABLES LIKE 'gtid\_mode'': Native table 'performance_schema'.'session_variables' has the wrong structure (1682)

In der Folge wurde kein Backup erstellt.

Die Lösung für dieses Problem fand ich nach kurzer Internetrecherche im Werkzeug mysql_upgrade. Dieses Programm untersucht alle Datenbanken und Tabellen auf Kompatibilität mit der aktuell installierten Version des MySQL-Servers. Dabei werden die entsprechenden Datenbanken und Tabellen falls nötig automatisch aktualisiert. Die Manpage (MYSQL_UPGRADE(1)) empfiehlt die Ausführung des Programms nach jedem Upgrade von MySQL.

Achtung: Das im Folgenden gezeigte Kommando hat mein Problem zwar gelöst, jedoch erfolgt die Ausführung auf eigene Gefahr. Ich selbst habe das Kommando das erste Mal verwendet und bin alles andere als ein Experte dafür. Dieser Post dient mir vor allem zur Erinnerung, wie ich das aktuelle Problem lösen konnte.

Das aktuelle Problem wurde wie folgt gelöst:

  1. Sicherstellen, dass MySQL läuft mit sudo systemctl status mysql.service
  2. Ausführung von mysql_upgrade -u root --skip-sys-schema
  3. Neustart von MySQL mit sudo systemctl restart mysql.service

Fertig. Hoffentlich erinnere ich mich beim nächsten MySQL-Update an diesen Beitrag.